AI已经能听、能看、能回答。
但面对持续变化的对话,它如何一边回应,一边保持理解与推理?
当你让AI分析屏幕上的图表,又突然补充「等一下,看右边那条曲线」,系统需要停止旧回答、更新目标,并检查后台计算是否仍然有效。
实时交互的难点,就在这些瞬间。
伊利诺伊大学厄巴纳—香槟分校、卡内基梅隆大学、哥伦比亚大学等机构的研究人员最新提出的综述提出了连接全模态智能与交互能力的统一概念框架,系统梳理从流式表征、模型架构、训练方法到实时部署与评测的技术链路,并进一步总结智能与交互之间的关键权衡及未来研究方向。
论文地址:https://doi.org/10.13140/RG.2.2.20245.69602
项目地址:https://github.com/ShenYifanS/Awesome-Interactive-Omni
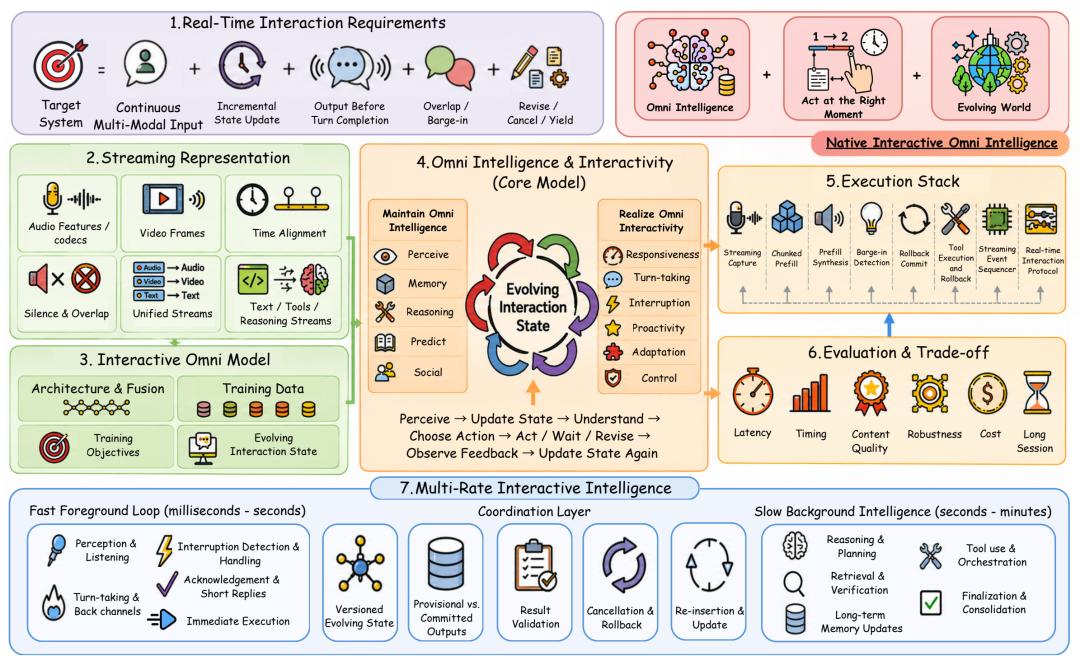
图 1|综述共总结了349篇工作,提出统一概念框架,将全模态智能与交互能力作为两个相互关联的组成部分,串联表示、架构、训练、部署与评测。来源:论文 Figure 1。
实时交互全模态智能
Omni AI(全模态智能)追求对文本、图像、音频和视频等多种模态的统一理解、推理与生成。但具备多模态能力,并不意味着具备自然交互能力。
综述将实时交互式全模态智能划分为两个相互关联的组成部分:
Omni Intelligence(全模态智能): 关注跨模态理解、推理与生成。
Omni Interactivity(全模态交互): 关注回应时机、轮次管理、打断处理和动态调整。
论文进一步总结了三个关键特征:流式输入、持续演进的内部状态,以及在线响应控制。这意味着模型需要持续接收信息、更新判断,并动态决定何时回应、等待或修订输出。
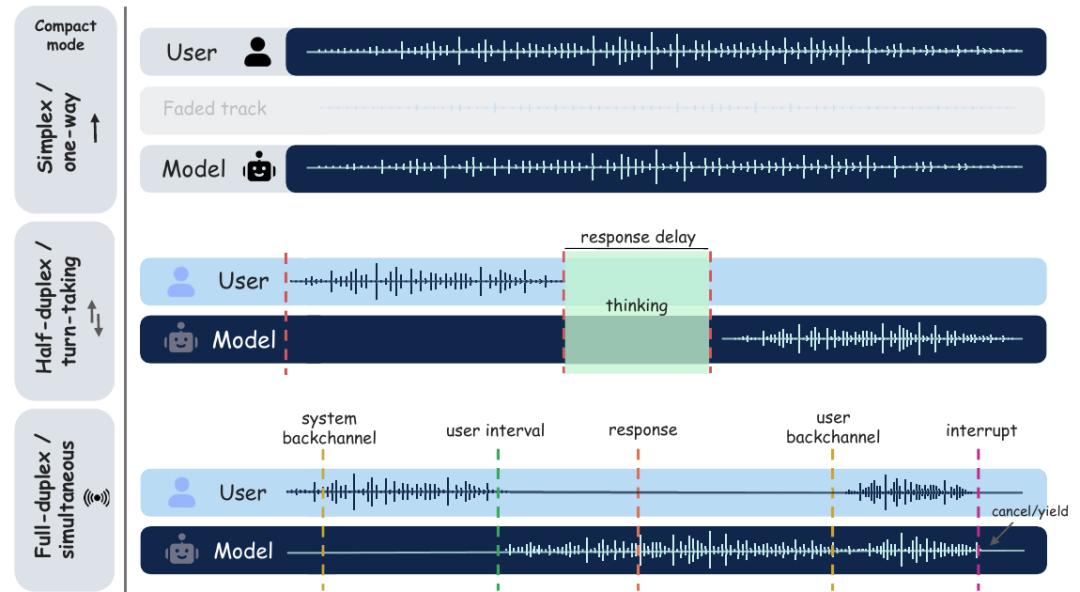
图2|全双工交互允许同时听说,并需要处理附和、语音重叠与打断。「原生」进一步强调,时间对齐、增量处理和交互控制被纳入模型架构与训练本身。单纯降低回答延迟,还不足以覆盖这些要求。来源:论文 Figure 2。
两条技术路线
在统一概念框架下,综述归纳了两条主要技术路径。
一是基于现有模型进行适配。通过流式处理、模态模块、后训练和外部编排,为预训练语言模型或全模态模型增加实时交互能力。优势是复用已有能力,挑战在于延迟、状态同步与打断控制。
二是构建原生交互模型。将连续多模态处理、时间结构和交互控制融入模型架构与训练,实现更紧密的感知与交互协同,但对训练数据和能力保留提出了更高要求。
何时开口,如何应对打断?
实时交互要求模型准确判断何时回应、等待,以及如何处理中途打断。
围绕这些问题,综述系统梳理了响应时机控制、轮次管理与打断恢复机制,分析了现有方法如何结合语音、视觉、语义和任务状态,实现动态交互决策。
在训练层面,文章总结了如何利用停顿、附和、语音重叠、纠正与沉默等交互信号,让模型不仅学习回答什么,也学习什么时候回答。
针对打断后的交互恢复,综述进一步归纳了六个关键环节:
检测(Detect): 识别用户是否真正发起打断,区分有效指令与背景声音。
让出话语权(Yield): 及时停止或降低当前语音输出。
回退(Rollback): 对齐用户实际听到的内容。
取消(Cancel): 中止过时的任务。
修订(Revise): 根据新指令更新意图和任务。
恢复(Resume): 基于更新后的状态继续交互。
兼顾智能与交互
面对复杂推理和工具调用,模型过早回答可能导致信息不足,而等待计算完成又会影响交互体验。
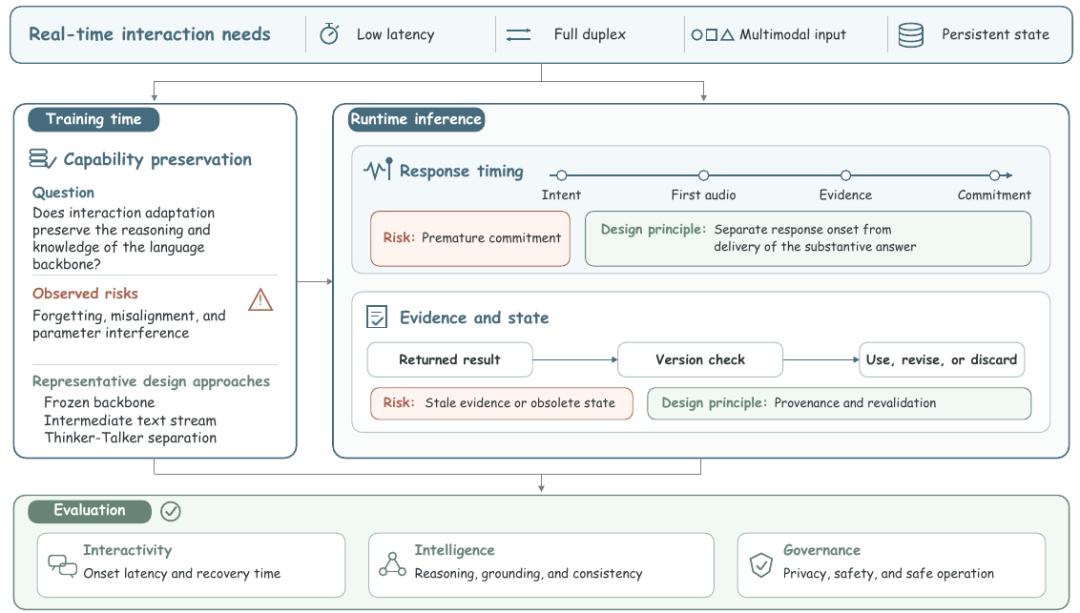
综述将这一问题概括为智能与交互之间的权衡(Intelligence–Interactivity Trade-off):训练阶段关注交互适配对原有能力的影响,运行阶段则需要平衡响应速度与答案质量。
图 3|智能与交互之间的权衡:训练阶段关注能力保留,运行阶段关注响应时机与任务完成质量。来源:论文 Figure 14。
为应对这一权衡,综述进一步讨论了多时间尺度交互智能(Multi-Rate Interactive Intelligence),通过协调快速响应与较慢的推理、检索和工具调用,兼顾交互实时性与复杂任务处理能力。
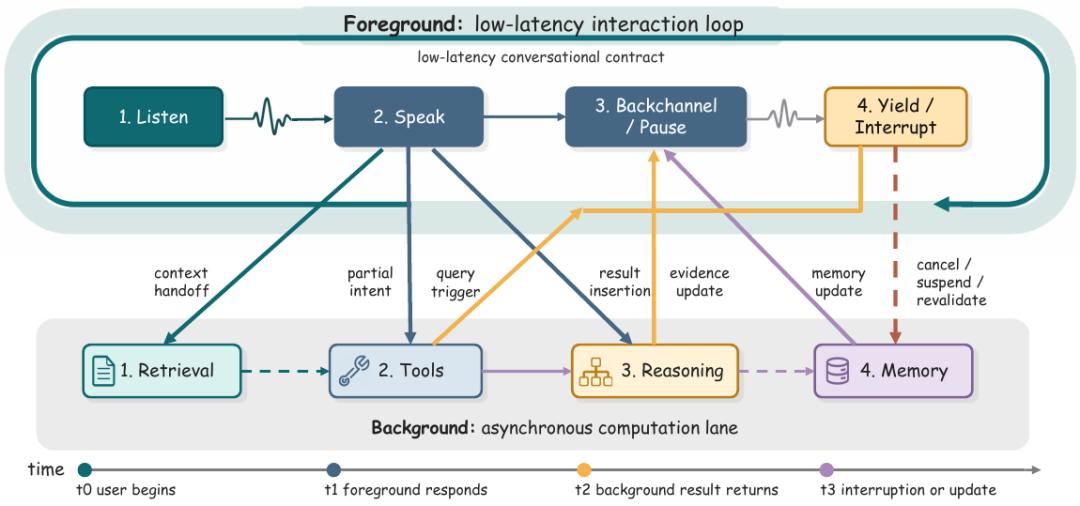
一种实现思路是前后台协同,前台负责持续感知和快速响应,后台异步执行复杂推理与工具任务,并通过状态同步避免使用过时的计算结果。
图 4|前台维持低延迟交互,后台异步执行检索、工具调用、推理和记忆操作。来源:论文 Figure 6。
评测与展望
针对现有评测难以同时衡量回答质量与交互行为的问题,综述从延迟、时机质量、内容质量、鲁棒性、长会话质量和修复能力六个维度系统整理了现有评测方法,强调需要在可比较的交互场景与资源预算下,同时衡量智能水平与交互表现。
综述进一步总结了四个值得关注的未来方向:
多时间尺度协同: 协调不同时间尺度下的感知、推理与交互。
持续状态与长期记忆: 维护长时间交互中的任务状态与记忆。
主动与社会性交互: 判断主动回应时机,理解多人交互中的角色与权限。
开放环境中的安全与效率: 兼顾安全、计算成本与系统可靠性。
从「能听、能看、能说」,到持续理解、适时回应并动态调整行动,是实时交互式全模态智能下一阶段的重要研究方向。
参考资料:
https://doi.org/10.13140/RG.2.2.20245.69602
本文来自微信公众号“新智元”,作者:LRST,36氪经授权发布。