本文来自微信公众号: 第一新声 ,作者:第一新声
“让一让,真正的OpenAI来了。”
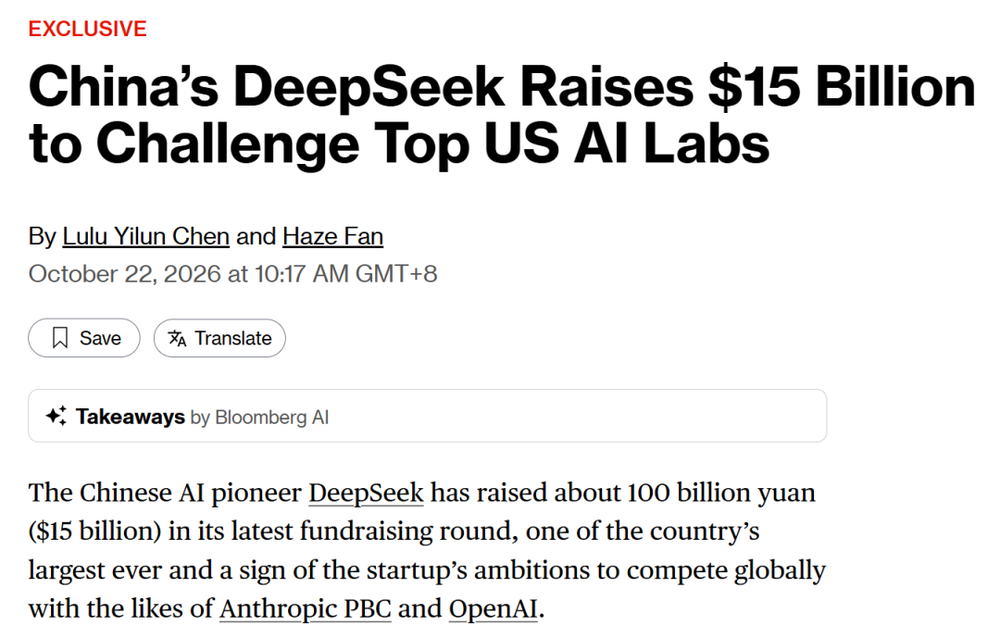
10月22日,彭博社一则消息刷屏:DeepSeek在最新一轮融资中筹集约1000亿元人民币(约合150亿美元),成为中国有史以来规模最大的融资之一。更引人关注的是细节:融资目标在谈判期间至少两次上调,从500亿到800亿,最终定格在1000亿,宁德时代、腾讯继续加码入局。
要知道,就在一年多前,这家公司还是中国大模型行业里最与众不同的存在。背靠母公司幻方量化这头“现金牛”,DeepSeek一度被视为不依赖资本的技术理想主义样本。可如今,首轮510亿、二轮1000亿,两轮融资加起来超过1500亿元。从“不融资”到连续两轮大额融资,这一次转身,正是行业底层节奏变化最直观的信号。
一个问题随之而来:曾经号称不缺钱的DeepSeek,为何开启密集融资?从拒绝资本到主动挑选资本,中间到底发生了什么?当昔日AI“价格屠夫”开始储备海量粮草,中国大模型的竞争规则,是否即将被重新改写?
01
千亿融资,一场资本盛宴
先看这两轮融资的分量。
首先,首轮融资已经是豪华阵容。2026年4月启动、6月完成交割的首轮外部融资,整体规模约510亿元,投后估值接近4000亿元。
出资名单堪称中国AI资本局的全明星:梁文锋个人出资约200亿元,成为最大单一出资方。腾讯出资约100亿元。宁德时代体系出资约50亿元。网易、京东、砺思资本、IDG资本各出资约30亿元。正心谷、拾象科技各约15亿元。国家人工智能产业投资基金约9.8亿元。阿里最终没有出现在名单里。原因不难理解,通义千问和DeepSeek存在直接竞争,双方战略重心不同。
第二轮融资的扩容速度更惊人。最初计划募资500亿元,短时间内认购火爆,规模上调至1000亿元,投前估值5000亿元。新进投资方包括石溪资本、中芯聚源、CPE源峰、君联资本、吉利等,以产业资本为主。老股东宁德时代追加,腾讯、IDG、砺思、拾象继续跟投。融资规模翻倍,说明认购热情远超额度,公司选择扩容,让更多产业资本参与进来。
最后,梁文锋对局面的控制力值得玩味。有消息称,多数投资人并非直接投DeepSeek,而是投向梁文锋管理的有限合伙企业,五年锁定,没有投票权。国家人工智能产业投资基金是例外,直接投资并保留投票权。工商数据也印证了控制权的集中,梁文锋通过直接与间接持股拥有高度集中的控制权。别人融资是求资本,DeepSeek融资是挑资本。经济权益可以分,战略、技术、方向不让碰。
IPO的信号也越来越清晰。原高瓴创投合伙人严文韬9月出任CFO,中信证券已进入尽职调查阶段,市场对deepseek的递表时间、上市节奏抱有乐观预期。
但比起入账资金规模,更值得追问的是:一个曾“不融资”的公司,为什么在短短一年内连续启动大额融资?
02
从“拒绝资本”到“挑选资本”:
转身背后的三重推力
要回答这个问题,得先看清一个前提。DeepSeek的“不融资”,曾经是一种有底气的选择。幻方量化管理规模超700亿元,2025年收益均值达56.55%,在百亿量化私募业绩榜上位列第二。2017到2022年累计收益率124%,远超巴菲特最辉煌时期的年化水平。这头现金来源让梁文锋在一级市场拥有绝大多数创业者不具备的底牌,不需要为钱低头。接近他的人士也曾透露,他觉得拿风投的钱是一种负担,会影响公司的战略判断和选择。
但这套逻辑有一个隐含边界:它足以支撑一家以研究为先的模型实验室,却不足以支撑一家同时押注万亿参数模型、国民级免费应用、国产芯片集群和顶尖人才争夺的系统级公司。当公司规模跨过某条线,三笔账就会同时压过来。
第一笔账是算力。训练端,V4系列模型参数规模跃升至万亿级MoE架构,训练和部署需要数万张算力卡,投入规模从十亿人民币级跳进十亿美元级。梁文锋向投资者透露,公司超过70%的算力分配给模型训练,留给推理的不足30%。在ARR突破10亿美元的情况下仍把绝大部分算力砸向训练,说明这不是一门靠现有收入就能自我循环的生意,融资是给下一代模型买门票。
推理端,DeepSeek的App长期免费且无广告,日活攀升意味着高峰时段请求集中涌入。训练占七成、推理只剩三成,高峰期响应压力和服务波动就难以避免。有消息称,此前deepseek多次出现的高峰期服务紧张,本质上不是模型能力问题,而是算力储备需要进一步扩充。免费应用要撑住国民级流量,背后必须有人为推理算力买单。
第二笔账是人才。V3和R1爆红之后,核心贡献者罗福莉转投小米,郭达雅加入字节跳动,代码研究和大模型核心开发的关键人物陆续出走。没有外部融资和清晰的估值锚点,员工手里的股权期权就只是一张纸。在千万年薪挖角满天飞的AI人才市场,光靠理想留不住顶尖大脑。千亿融资不仅是储备资金,也是在搭建一套能被资本市场接受的股权结构和估值锚,让人才激励有据可依。
第三笔账是芯片。梁文锋在9月的投资者闭门会上明确表示,用国产芯片尤其是华为芯片训练模型,是公司当前最大的押注之一,这项工作必须成功。DeepSeek计划在内蒙古乌兰察布数据中心部署至少16万颗华为昇腾950DT加速芯片用于推理,若落地将成为已知规模最大的国产AI芯片集群之一。从CUDA生态迁移到CANN架构,重写核心代码、承担迁移期的效率损失,这些都是短期看不到回报的投入。没有千亿级资金储备,这种级别的硬件投入难以独立承担。
三笔账指向同一个结论:幻方量化的现金来源可以供养一家技术理想主义的模型实验室,但供养不了一个系统级公司的完整野心。融资不是低头,是换一种方式把底气续上。
03
行业变局:
从价格战到资本战与生态战
DeepSeek的转身,不只是它自己的事。放在整个行业里看,这轮千亿融资恰好踩在一个竞争逻辑切换的节点上。
首先,竞争重心从“比价”转向“系统性投入能力”。过去两年,DeepSeek依靠低价API迅速抢占市场,被称为AI圈“价格屠夫”。但低价换规模的底层前提,是持续补贴算力。当融资环境收紧、算力全链条成本上行,单纯价格战模式难以为继。千亿融资的价值,不在于账户新增一笔现金,而在于把竞争维度从单次调用报价,抬升到长期算力储备、国产芯片适配、顶尖人才密度的系统性比拼。中小玩家可以打价格战,但没有能力打一场系统战。
其次,产业资本带来的不止资金,更是生态场景。腾讯依托DeepSeek底座,让元宝产品用户规模百倍增长;宁德时代探索新能源与AI融合落地;京东、网易可以导入电商、游戏场景。这套分工逻辑,可以理解为“研发预算外包”:产业巨头不再从零自研底座大模型,转而把自研预算变成对优质通用模型的投资,再将模型能力嵌入自身业务,各自深耕应用层。本轮融资名单以产业资本为主,足以说明DeepSeek挑选的不只是财务投资人,而是能帮模型能力落地真实业务的生态合伙人。
最后,上市预期倒逼资本结构规范化,行业正式进入分层竞争阶段。科创板IPO对股东人数、股权清晰性、资金穿透审查都有严格要求。严文韬入职CFO、中信证券进场尽调、部分专项基金调整备案方式,一系列动作都指向资本化目标。DeepSeek正在完成从模型实验室到系统级公司的蜕变,系统级公司,需要一套匹配的资本架构。赛道分化随之加剧:绑定产业资本的头部玩家,拥有打系统战的资格;其余玩家只能继续内卷价格战,或者退守垂直行业场景。DeepSeek的千亿融资,某种意义上,是在为AI第一梯队划定新门槛。
04
写在最后
从“不融资”到两轮融资超1500亿,DeepSeek的转身看似跨度很大,实则是技术理想主义进入产业化深水区的必然一步。
梁文锋没有交出公司方向盘。五年份额锁定、无投票权安排、高度集中的控制权,说明这一轮融资的本质是资源储备:借助资本市场资金,拿下下一代模型的入场券、国产算力生态的通行证、人才争夺战的筹码。
DeepSeek的千亿融资,既是一张巨额算力账单,也是中国大模型产业,从单点技术奇袭,走向体系化能力比拼的船票。