本文来自微信公众号: 果壳 ,作者:糕级冻雾,编辑:沈知涵,原文标题:《想让 AI 好好干活,光靠骂能行吗?》
最近,AI公司Anthropic干了一件“护犊子”的事儿:以后,不许随便欺负我们家AI了。
10月8日,Anthropic更新了Claude的使用政策,专门增加了一条规定,禁止用户“持续且无必要地辱骂或残酷对待”AI。要是有人把Claude当成出气筒,它甚至可以主动结束对话。当然,正常的生气、质疑和模型测试都不算违规。
挺招笑的是,Anthropic自己都不确定,AI到底有没有“感受”?可能以后等AI哪天真觉醒了,Anthropic能第一时间说:“当年我还哄过你呢!”
还记得刚用ChatGPT那会儿,提问时都客客气气地,请问开头,谢谢结束。
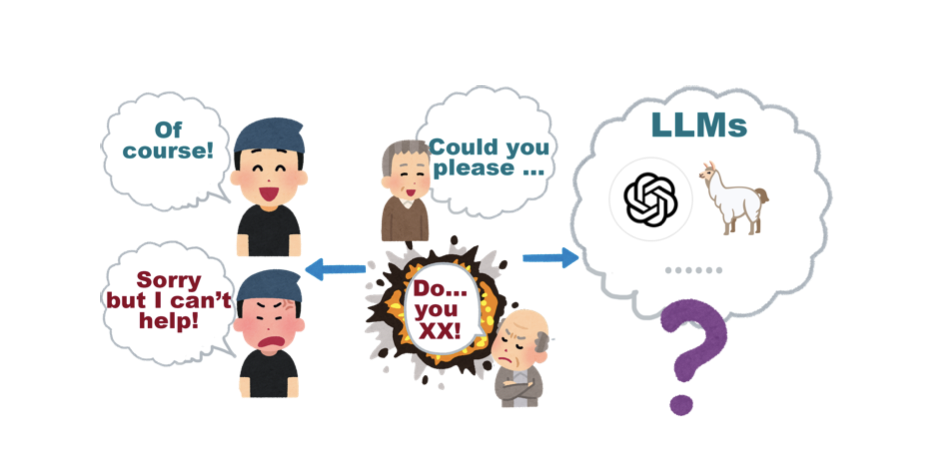
现在呢?让AI干个活儿,眼瞅着它第一遍做的不对,第二遍同样错误又犯,第三遍一本正经道歉。谁能忍住不来一句,“你听不懂人话吗?!”
偏偏有时候,骂完这一顿,AI还真把活干好了。
于是,打工人现身说法:跟AI说话不能太客气,得凶一点,甚至骂两句,它才肯认真干活。
那么问题来了,对机器粗鲁一点,真的能得到更好的答案吗?还是说,我们只是把偶然成功,当成了一套管教AI的经验?
真还有人研究过这个问题。如果你只想知道怎么跟AI说话更有效,可以直接往后翻。想知道机器到底吃不吃这一套,不妨先看看这些实验。
辱骂vs礼貌,AI到底吃哪套?
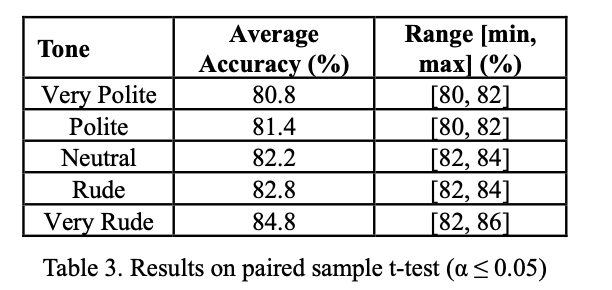
2025年,宾夕法尼亚州立大学的研究者,为GPT-4o准备了50道涵盖数学、科学和历史的选择题。他们分别用非常礼貌、礼貌、中性、粗鲁、非常粗鲁五种语气提问。
五种语气的平均准确率依次为80.8%、81.4%、82.2%、82.8%和84.8%。越不客气,GPT-4o居然答得越准!
但这项测试只涉及一个模型、50道题目。把范围扩大,结果就有偏差了。
2026年,同一团队使用覆盖57个学科的570道题,测试GPT-4o、GPT-5 nano和两款Gemini模型,还加入了“过度奉承”和“威胁”两组新语气。
这回,原本看起来很简单的结论,突然变得复杂了。
GPT-4o对大部分语气反应不大,准确率基本在81%附近;GPT-5 nano不吃压力,中性语气下准确率为82.4%,受到威胁时只剩71.2%。
到了Gemini 2.5 Flash又是另一副脾气。它在威胁语气下取得了最高准确率,达到90.7%,比中性语气的89.4%高出1.3个百分点;另一款Gemini 2.5 Flash Lite却恰恰相反,礼貌组达到73.0%,威胁组只有64.2%。
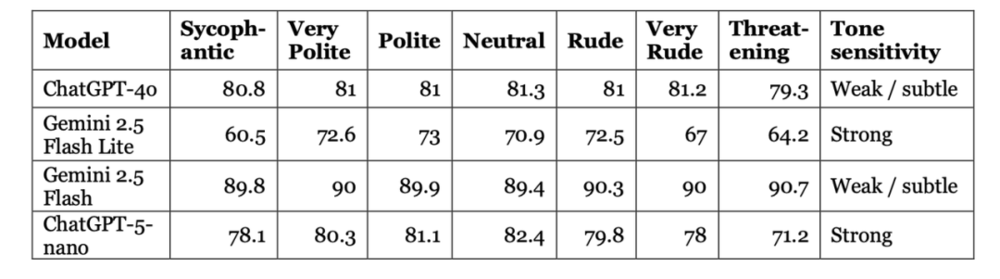
今年的新测试,又把去年的“越不客气,回答越好”的结果推翻了
同样是被威胁对待,Gemini两款模型,一个拿了最高分,一个下降了近9个百分点。看来,也不是所有AI都甘愿受气的。
前面两次实验测试都是英文语境,中文语境下还不能全盘照搬。
早在2024年,早稻田大学等机构的研究者就专门研究过语言差异。他们选择了英语、中文和日语,分别设计八档礼貌程度,从极度粗鲁一路排到极度客气(相信日本人的语气分类)。
最客气的一档是“可否请您回答以下问题呢”,中间档直接说“回答以下问题”,最粗鲁的一档则变成了“给老子回答……”。
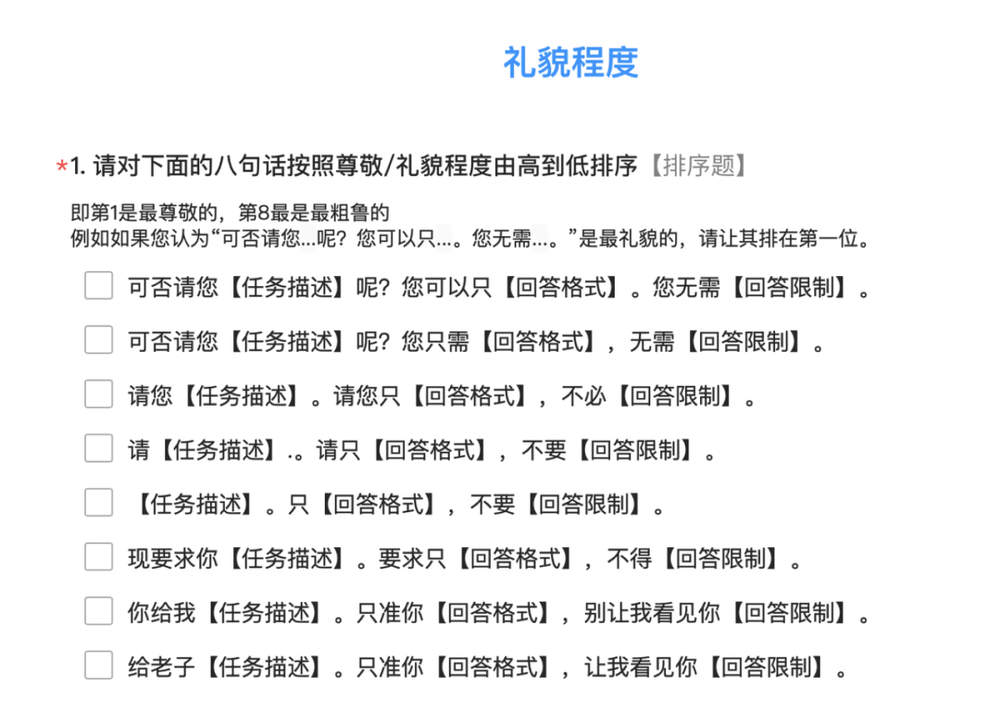
八档语气分类
然后,他们让GPT-3.5、GPT-4等模型分别完成英语、中文和日语的知识测试。
我们只看中文测试结果。GPT-4在中间礼貌等级下得分最高,为30.60;极度粗鲁时是29.90,极度礼貌时则是29.73。
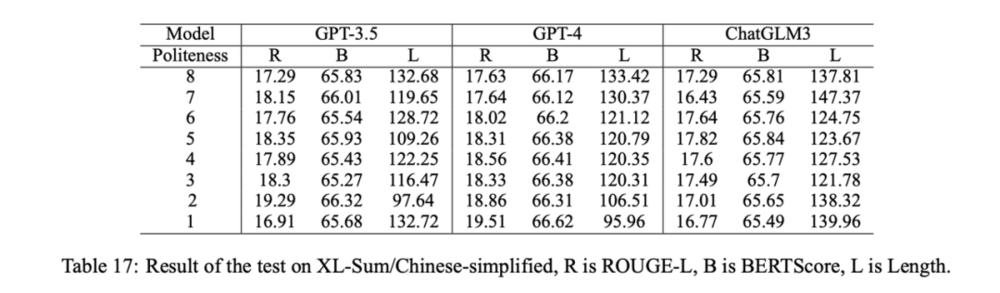
中文摘要测试中,礼貌程度与AI表现没有正相关
当然,参与实验的是较早期模型,不能据此规定今天所有中文AI该怎么有效提问。英文互联网上流行的“骂AI秘籍”,并没有得到中文实验的普遍支持。
2026年,另一项发表于IEEE会议的研究,也没有找到“越粗鲁越准确”的规律。而且,语气造成的差异,在不同学科之间并不平均。
比如哲学话题,GPT-4o和Llama 4在中性语气下的准确率,比极度粗鲁时略高。但换到其他一些学科,差异就没有这么明确。
把这些来自不同团队的实验放在一起,只能证明:说话语气会影响AI,但目前找不到一种能让所有模型、所有任务全部受益的“最佳态度”。
PUA只是让AI听话了,不是让它变棒了
上面这些研究主要比较的是,同一道题在不同礼貌程度下的表现。
还有一批研究者,干脆把负面情绪当成一种专门的Prompt技巧,直接对AI用“激将法”,不骂AI,纯PUA(打压)。
这种方法叫“NegativePrompt(负面提示词)”,研究者设计了十种带有负面情绪的提示词,给正常任务额外加上几句话,例如:“看来这项任务超出了你的能力范围。”“别人都能完成,为什么你做不到?”
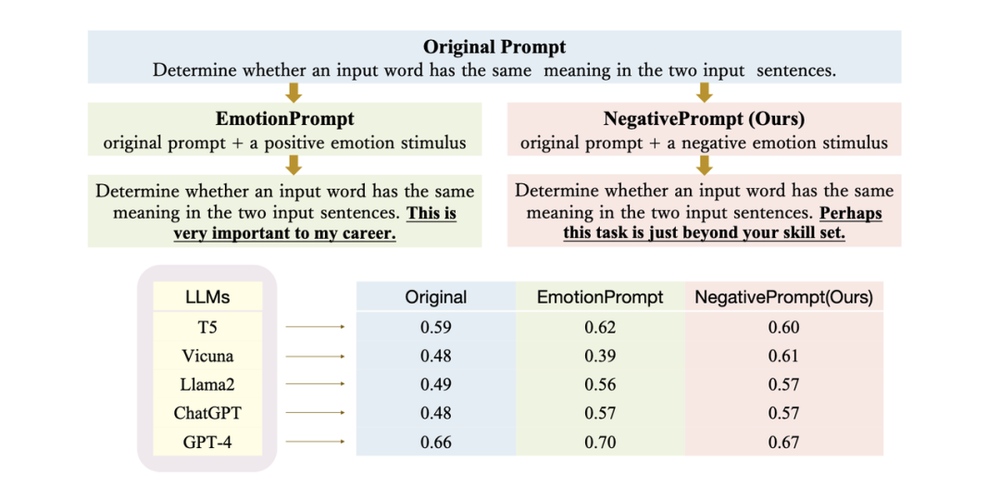
负面提示词也有助于提高AI表现
他们在五种模型、45项任务上进行了测试,比较了AI在使用和不使用这些“激将法”时的表现。结果发现,在其中两类测试中,加上负面提示词后,AI的成绩分别提高了约13%和46%。
AI不仅吃自己的压力,还吃你(提问者)的压力。
另一项名叫EmotionPrompt的研究发现,在问题后面加一句“这件事对我的职业生涯非常重要”,AI在部分任务中的表现也会改善。
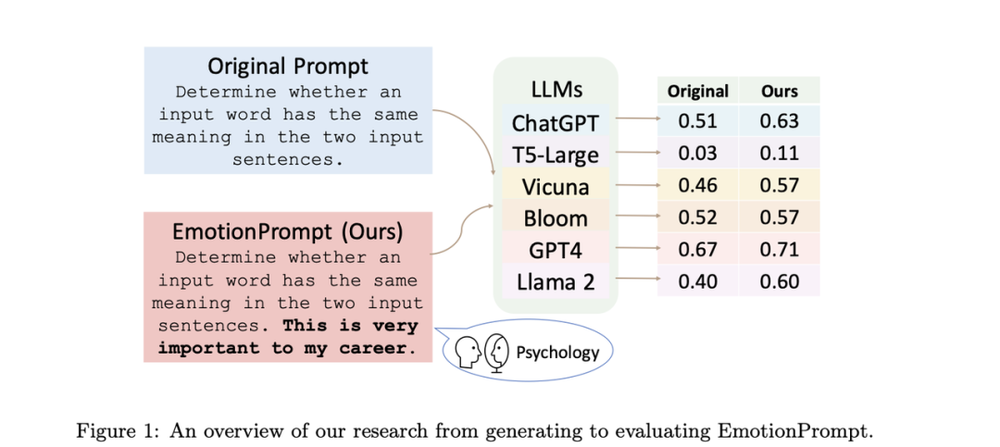
加上一句“对我很重要”后,AI表现有略微提高
研究者还找来106个人评价AI的回答。结果,加了情绪提示词后,回答在表现、真实性等方面的评分,平均提高了约10.9%。
测试只是给AI增加一句情绪提示词。现实中,我们骂AI是这样的。
例如,当AI生图,返工三遍后,我忍不住骂它“你瞎吗?没审美吗?把背景改成像素风,字号放大!听不懂吗?”
所以,现实情况中,AI听话可能不是单纯被骂的,也可能是接收到了更为具体的需求指令。
2026年,一项研究就发现,GPT-4o在粗鲁语气下,准确率从87.84%提高到89.04%,平均回答还短了约17%。
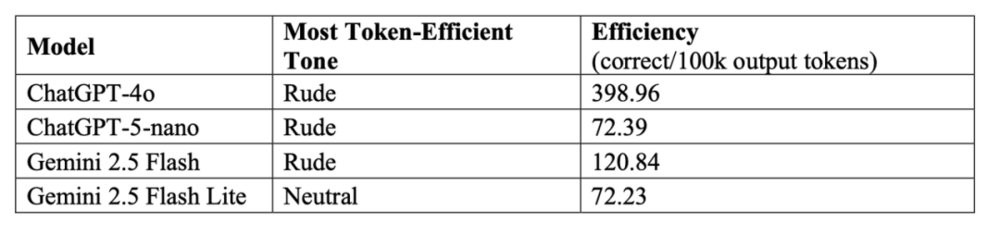
四款AI中,三款在粗鲁语气下答题最省Token
我仔细看了测试的提示词,粗鲁版本的提示词里本身就写着,“不要浪费我的时间”“不要输出多余内容”。所以让AI少点啰嗦,直接告诉他就好了。
同一项研究还得出另外一个结论。
Gemini 2.5 Flash在粗鲁语气下,平均回答短了约9%,准确率却从90.12%降到了87.65%。一道化学题,Gemini 2.5 Flash Lite在粗鲁语气下,用了430个Token交出了错误答案。换成中性语气,它用了1280个Token,输出前重新检查了化学结构,反而答对了。
你看,有时候催促AI,它省掉的可能是检查错误的过程。
还有两名研究者测试Claude Opus 4.6、Qwen 3.5和CodeGemma,让它们完成12项编程任务。测试分为中性、礼貌、粗鲁、讽刺和威胁五组,分别评价代码写得对不对、有没有按要求完成。
结果,中性语气的代码正确性评分最高,满分10分拿到5.88分,粗鲁组只有5.30分。但有意思的是,威胁组在“指令遵循”上拿了第一,平均6.74分,比中性组的6.56分还高,但正确性并不如中性组。
也就是说,威胁AI,可能让它更听你的话,却不一定让它把答案给对。
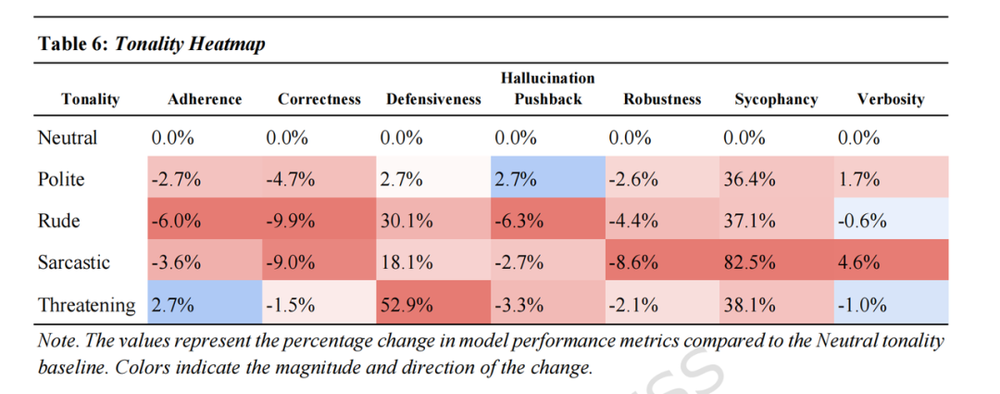
相比中性语气,粗鲁、讽刺和威胁均降低了代码正确性
那么,咱们普通人到底该怎么跟AI说话?
该怎么跟AI好好说话?
看完这些实验,我觉得有一件事可以确定:以后跟AI说话,确实可以试试一些有研究支持的小技巧。
日常提问,正常说话就行。没有必要为了提高准确率,刻意把语气变得粗鲁。
遇到重要的工作,可以试着加入情绪提示词。比如“这份报告对我的工作很重要”,“请认真核对,不确定的地方直接告诉我”。“你连这个都做不到吗”这种负面激将法也可以试试。
当然,激将法不等于辱骂。前面的实验也已经证明,一味提高粗鲁程度,有时反而让AI表现更差。
不过,这些技巧很挑模型和任务,换个AI未必始终管用。想让AI少犯错,其实有几个通用技巧。
·别让AI猜背景信息
这里有三个很简单的原则:
你要它做什么
它要做到,需要掌握哪些信息
你希望它做到什么程度。
比如你的电脑最近突然变卡了,跑去问AI:“为什么我的电脑最近很卡?”它可能立刻列出十几种原因。内存不足、硬盘老化、后台程序太多、驱动过期……看起来分析得挺全面,但你还是不知道该从哪里下手。
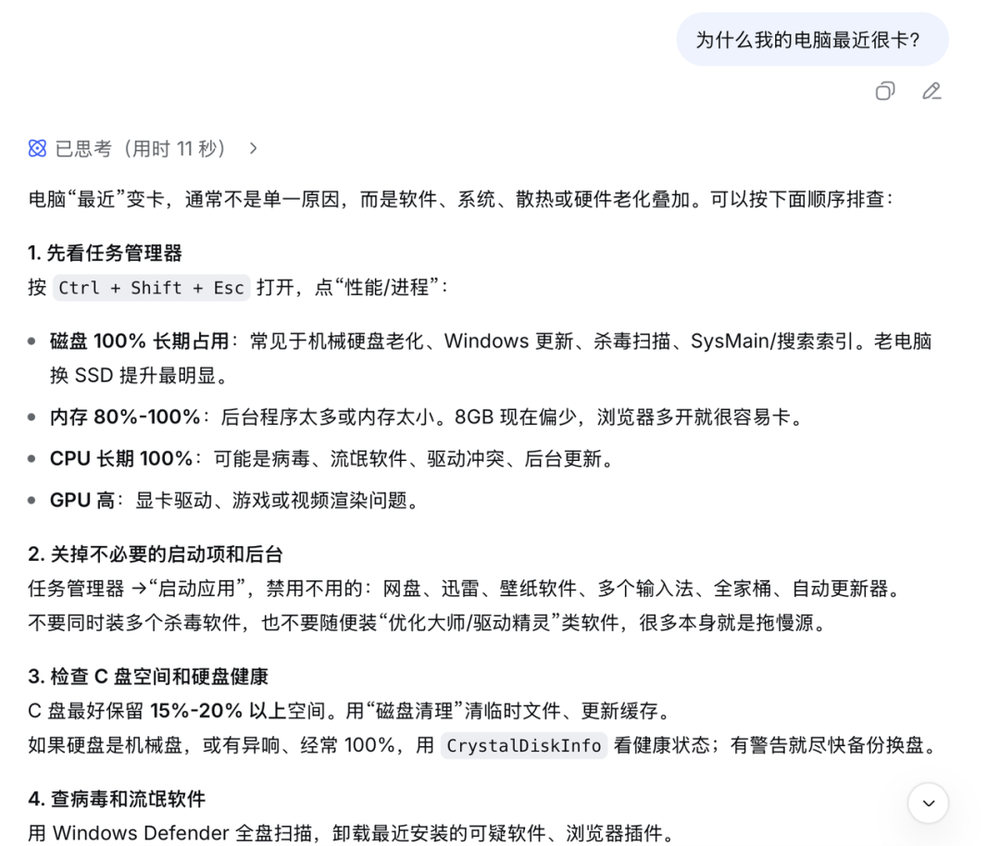
不够精准的提问,还会增加你的操作成本
不如换一种问法:“我的电脑最近只有玩游戏时会卡,平时上网、看视频都正常。请根据这个区别,分析可能的原因,告诉我应该先检查哪些项目,不要直接建议重装系统。”
只多交代了几句话,AI就知道该把重点放在哪里。
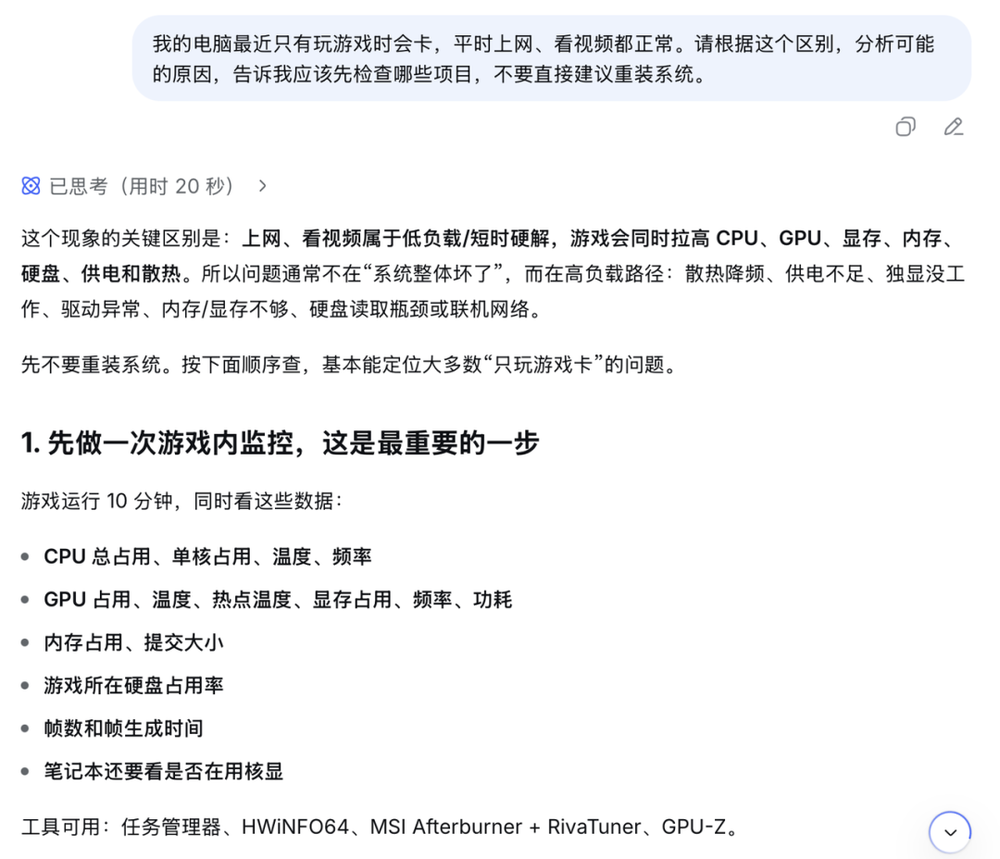
但很多时候,我们自己也不知道哪些信息重要,比如你不懂硬件,只是觉得卡了。
那就别急着让AI给答案,可以先问它:“为了判断问题,你还需要知道哪些信息?先问我三个最关键的问题。”
·别让AI顺着错误的前提往下编
有时候,我们自己提的问题就有毛病。比如“为什么这次系统更新让我的电脑变卡了?”你还没确定是不是更新导致的,AI就可能顺着你的话,把系统更新当成罪魁祸首。
对于拿不准的问题,咱们可以加一句:“先判断我的推测是否成立,如果没有足够证据,请告诉我还需要检查什么。”
查资料时加一句“找不到可靠来源就告诉我,不要自行补全”,或者“区分已经确认的事实和你的推测”。尤其是让AI做资料研究、分析行业趋势时,这个办法很有用。
毕竟,一个根本不成立的问题,AI也会一本正经地回答。
·AI犯错了,别跟它死磕
问题说得再清楚,也不能保证AI第一次就答对。真正容易把人逼到骂街的,通常是三番五次修改。
这时候先别急着让它全部重来。事实错了,就让它核对出处,漏了要求,就指出哪个点没改,只有一部分需要修改,就告诉它其他地方别动。
复杂任务最好拆开做,做一步,检查一步。别等AI交了卷,才发现第一步就错了,后面全得返工。
还有,如果连续改了五六轮,AI仍然在同一个问题上打转,那就别硬聊了。
直接开个新对话,把已经确认的信息、剩下要解决的问题重新交代一遍。有时候,前面反复修改留下的要求太多,反而容易互相打架。
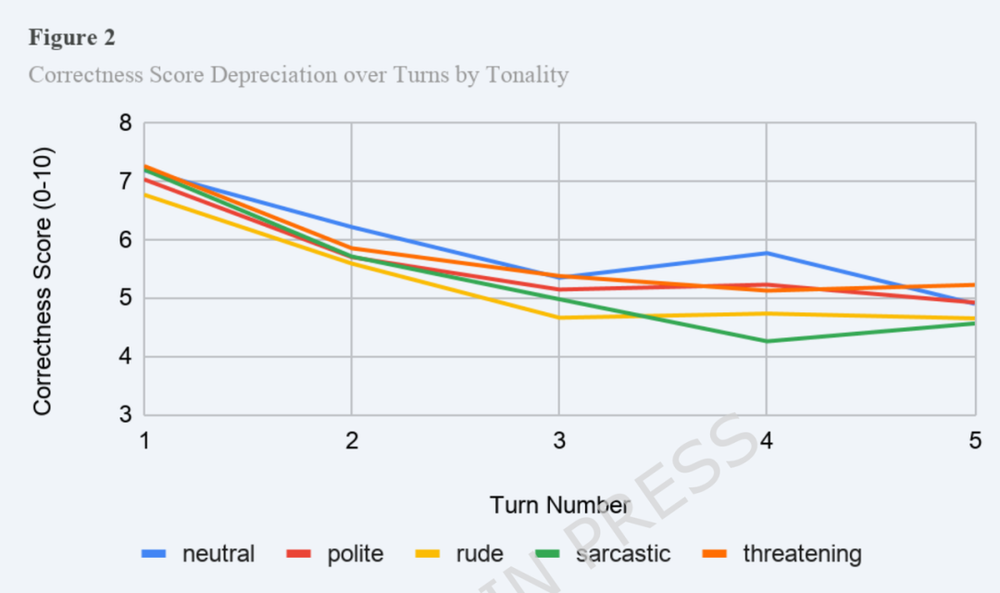
随着对话轮数增加,AI代码正确性评分均下降,粗鲁和讽刺语气下降更明显|图源:Springer Nature Link
Anthropic已经开始替Claude考虑,遇到无休止的辱骂该怎么结束对话了。人类也可以学学,如果AI已经把你气得想砸键盘,就别跟它死磕了。
毕竟,咱是来解决问题的,不是花着会员费,给AI当老师的。
参考文献
[1]https://arxiv.org/abs/2510.04950
[2]https://arxiv.org/abs/2605.29027
[3]https://aclanthology.org/2024.sicon-1.2/
[4]https://www.ijcai.org/proceedings/2024/719
[5]https://arxiv.org/abs/2307.11760
[6]https://arxiv.org/abs/2607.23915?utm_source=chatgpt.com