本文来自微信公众号: AGI 2050 ,作者:AGI 2050,原文标题:《图灵奖得主杨立昆最新演讲:生成式 AI 是一条死胡同,世界模型才是真正的未来》
1956年盛夏,达特茅斯学院的那场学术研讨会,正式开启了人类探索“人工智能”的历史。七十年后,在这座见证AI诞生的礼堂里,图灵奖得主、纽约大学教授、Meta前首席AI科学家、AMI Labs创始人兼董事长杨立昆(Yann LeCun)获颁“AI七十年杰出贡献奖”。
获奖后,杨立昆发表了长达一小时的演讲。演讲中他指出,通用智能的真正钥匙不在语言里,而在对物理世界的抽象建模中。他系统性阐述了基于“联合嵌入预测架构”(JEPA)的分层世界模型,呼吁整个行业彻底推倒现有范式,迈向由真实物理常识驱动的下一代自主机器智能。
本期内容来自达特茅斯学院AI@70大会,2026年10月29日演讲,原视频时长64分钟。
以下为精选演讲内容,全文约7600字,阅读时长约5分钟。
今天,我想聊聊AI的未来,也会穿插谈谈现状与历史。
我的核心判断是:AI若想取得实质突破,必须依赖全新的理论概念。现有的技术路线根本没有解决问题。尽管硅谷一些极其乐观的CEO天天高调吹捧,但我们距离真正的人类水平智能——也就是某些人所谓的AGI——还差得十万八千里。我很讨厌AGI这个说法,稍后我会解释原因。
至于“什么必须保留给人类”这类哲学问题,除非待会儿提问环节有人专门问起,否则我今天就不展开回答了。
一、现在的AI到底有多弱?
开门见山地说:目前的AI其实很差劲。
过去七十年里,我们确实让机器变得更聪明、更实用。现在的系统能写代码、能过司法考试、能在国际奥数竞赛中拿金牌,甚至能证明悬而未决数十年的数学难题。
可我们的家务机器人呢?L5完全自动驾驶汽车又在哪里?
一个都没有。
这恰恰说明:现有AI能熟练处理离散符号、语言、代码和数学,可一旦面对真实物理世界,便立刻手足无措。真实世界复杂、混乱且充满噪声,当前的AI架构对此基本束手无策。它根本无法消化图像、视频、音频这类高维连续信号。
虽然有些系统能处理一部分图像或声音,但所用技术完全不能同日而语。当前各家AI公司的标准做法,无非是在大语言模型(LLM)周围生搬硬套各种外挂模块:加个工具调用插件,焊上几个视觉编码器,再拼装一层语音识别。LLM依旧稳居核心。我们手里根本没有一种通用的学习机制,能让系统自主理解高维、连续且混乱的现实信号。
再看那些所谓的智能体。它们主要依赖“模仿学习”来复刻人类行为,动辄需要吞下海量样本,或者依赖算力堆砌的模拟环境。更致命的是,它们完全不具备预判自身行为后果的能力。这在现实中极其危险——如果你连自己迈出一步会导致什么都无法预判,便随时可能闯下大祸而不自知。
这引出了一连串问题:为什么AI无法在没有海量训练样本的情况下,零样本解决新问题?为什么机器至今没有常识?
答案很简单:语言是高度抽象、被高度简化的符号,而真实世界极其复杂。
别说达到人类智能了,如今的机器人连猫狗对物理世界的理解水平都达不到。一个十岁小孩第一次听大人吩咐就能把餐桌收拾利落,没有任何AI能做到这一点。自动驾驶领域积累了人类数十亿小时的行车视频,照理说用神经网络模仿人类驾驶早该成功了,但事实证明,纯粹的“模仿学习”在这条路上彻底走不通。目前最先进的自动驾驶依旧卡在第四级(L4),必须依赖特定区域、严苛工程系统、高精地图以及激光雷达的辅助,根本实现不了全场景通用的L5自动驾驶。
我们一再撞上“莫拉维克悖论”——这是机器人专家汉斯·莫拉维克在1988年提出的洞见:对人类和动物极其简单的本能,对AI而言宛如天堑;反倒是人类觉得极难的事情,AI处理起来轻而易举。
这就逼着我们重新审视一个根本问题:究竟什么是智能?
我们日常接触各类AI助手,很容易产生它们具有智能的错觉。但实际上,除了在编程和纯数学领域偶有亮点,它们并不算真正聪明。它们擅长的是知识检索与记忆拼贴——囤积海量的陈述性知识,并在恰当时候“反刍”出来。可记忆不等于智能。
有一句流传甚广的话算在发展心理学家皮亚杰名下,其实他本人从没明确这么说过,但这确实是他的意思:“智能,不是看你掌握了多少既有知识,而是看你面对完全未知的境况时如何应对。”
我很喜欢这句话。当你身处全新境遇,没有任何历史训练数据供你照搬,你必须调动全部心智去推理、去寻找破局路径。现在的AI只会把已有知识“反刍”出来,除了代码、数学这类很窄的领域,并不能真正创造新知识。
因此,衡量智能的尺度,绝不该是一堆技能列表,也不该是回答问题的流利度,而是系统学习一项新技能或掌握新任务的速度——甚至能否无需预先训练,直接零样本搞定。
再来看看人类和动物是如何学习的。
人类婴儿在出生后几个月内便能迅速建立起对世界的基础认知。两个月大时,婴儿就能区分生物与非生物,并懂得“物体恒存”的概念;他们很早就明白桌子与椅子的类别差异,即便此时他们连名字都不会叫。至于重力、惯性、动量守恒这类“直觉物理常识”,婴儿大概要到九个月大才能自然领悟。
这种常识的形成并不全靠动手试错。在出生后的头三四个月里,婴儿连身体都无法自主控制,他们建立物理认知主要靠观察周围世界。
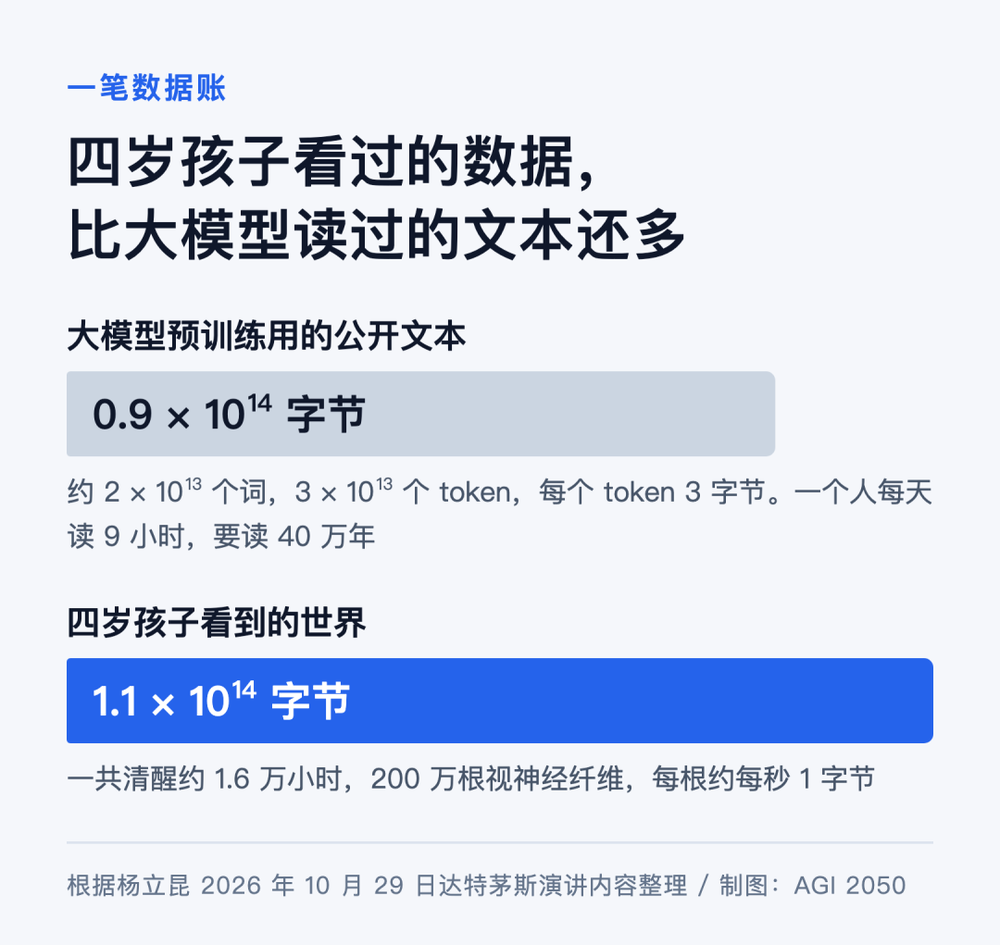
这揭示了另一个事实:当前大语言模型的预训练语料,几乎涵盖了互联网上所有能找到的公开文本,总量约为20万亿词(2×10¹³词),换算成Token约30万亿,折合约10¹⁴字节。普通人读完这些文本大概需要四十万年。
然而,一个四岁小孩清醒的时间总共约1.6万小时。人眼拥有两百万根视神经纤维,每根每秒向大脑传递约1字节视觉信息。按这个通量粗略计算,一个四岁小孩通过双眼和触觉接收到的物理数据,就已经达到了10¹⁴字节。
换句话说,一个四岁幼儿感知世界的数据规模,就已经堪比整个互联网的所有文本。指望单靠文本训练就让机器通向人类水平智能,从物理信息量的维度看就注定破灭。单纯的大语言模型永远不可能实现人类级别的认知能力。
二、思维模式的死胡同:前向计算vs.优化搜索
我们的大脑在思考时,究竟在运行何种推断机制?
是像前馈神经网络一样,把信号向前推进一遍就得出结论吗?显然不是。面对复杂问题,我们会驻足深思,耗费更多时间去推敲。除了某些烂熟于心的习惯动作,人类行动前必然会推演预测。
大语言模型完全不是这样运作的。它将一串词输入Transformer架构,逐层向前推进,最后吐出一个Token。这是纯粹的前向计算。你哪怕问它一个极度复杂的命题,只要让它回答“是”或“否”,它耗费的算力与回答一个常识问题毫无差别。
为了弥补这一硬伤,业内想出了“思维链”这种打补丁的办法:引导模型输出大段文字,以此伪装成思考步骤。但这并不是真正意义上的推理机制。
回溯经典人工智能、贝叶斯模型或控制理论,推断从不是单一的前向信号传递,而是一个搜索与优化的过程。
系统感知世界,提取当前状态,并在脑海中假想一个动作。随后,它借助一个目标函数来核验:假想的动作能否达成预定目标?你可以把这个目标函数理解为一个标量评估器,它输入当前观察和备选输出,打出一个分数,衡量该输出与当前观察的适配度。
因此,真正的推断过程是:系统在可能采取的行动空间中持续搜索与优化,找出能将目标函数代价降至最低的最佳动作,最终将其付诸实施。
从计算本质而言,基于优化的推断远胜于纯粹的前向计算。
虽然在理论上,你可以援引1989年乔治·西本科(他今天恰好就在台下)提出的著名定理——两层神经网络是通用函数逼近器,因而任何计算都能被单次前向传播替代。但在现实工程中,如果只用两层网络去拟合复杂搜索,所需的参数规模将膨胀至不可思议的量级,完全失去实用价值。
这就引出了认知科学中常说的“系统1”与“系统2”:
●
系统1:靠直觉即刻完成,前向推进,适用于轻车熟路的机械动作;
●
系统2:全力调动心智,通过优化与搜索反复审视后果,应对未知与复杂规划。
若想让AI产生真正的智能跃迁,核心攻坚方向必须是系统2。
三、破局方案:目标驱动型架构与世界模型
为了实现系统2,我构思了数十年,并在2022年系统性地梳理出了一套完整理论——《迈向自主机器智能之路》。
我将这套全新的设计方案称为目标驱动型架构。
整个框架的核心逻辑十分明晰:
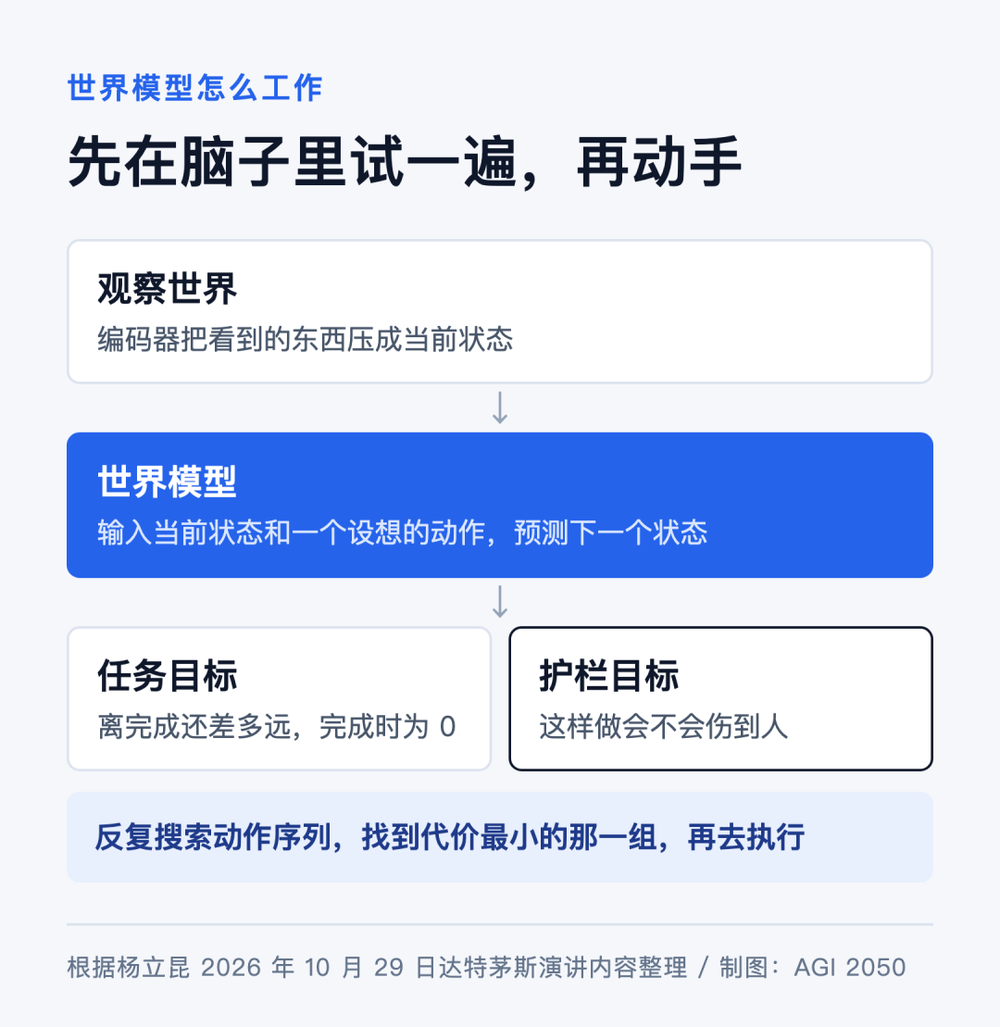
系统在时刻t接收物理世界的观察输入X(t);通过训练好的感知编码器,提取出当前世界的状态表征;随后,该状态被送入世界模型。
世界模型本质上是一个可训练的神经网络函数。它的核心任务是:根据当前状态与系统假想的一个候选动作a(t),预测出物理世界在下一时刻的状态S(t+1)。
接着,这一预测状态被输入目标函数。目标函数负责裁判任务完成度:若任务达成,代价值为零;偏离目标越远,给出的惩罚分值越高。
系统的运作核心,便是在动作空间中反复搜索、优化,寻找到一组能让综合代价最小化的动作序列。
如果我们希望系统不伤及无辜,还可以引入“护栏目标”。只要世界模型能预判行动的后果,我们就能在预测状态之上架设安全惩罚项。例如对厨房助理机器人设定底层物理红线:无论如何规划动作,只要身旁有人且手里握着菜刀,就绝不能挥舞手臂。这样便从底层数学约束上赋予了机器内在的安全性。
这套理念在经典控制工程中被称为模型预测控制,其思想早在上世纪五六十年代便已确立。如今的全新之处在于:我们必须用深度神经网络在抽象表征空间中自主训练出这个世界模型。
而要实现真正的自主推断,我们还必须攻克一个过去被视作无解的难题——分层规划。
人脑中从来不存在单一通用的世界模型。我们需要在不同时间尺度和抽象层级上建立多重模型:有的负责预测未来两百毫秒的肢体反馈,有的推演未来几分钟的路线,有的则规划未来一年的安排。
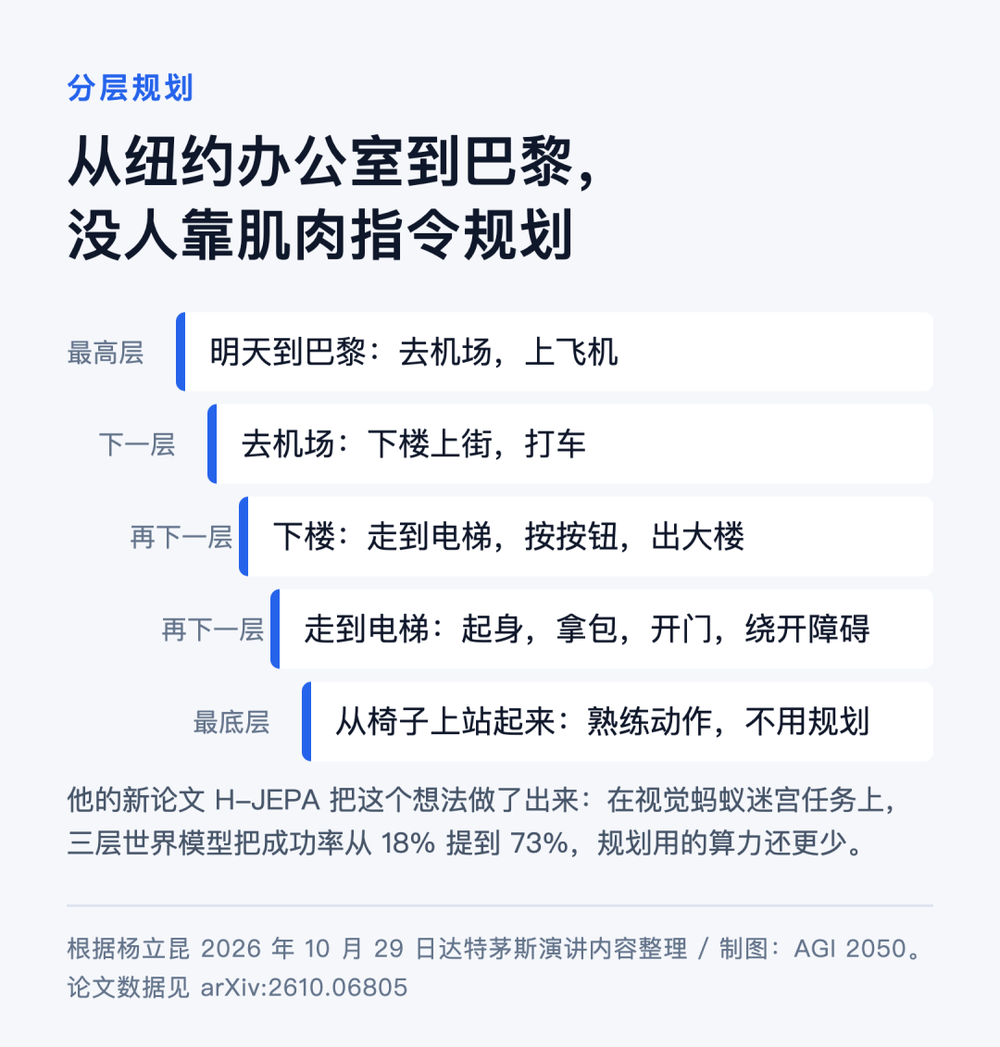
如果我现在身处纽约大学办公室,计划明天赶到巴黎,我绝不可能用肢体肌肉的微观神经信号来规划整个跨国行程。我必须在极高的抽象层面做分步推演:
1.第一层规划极度抽象:先去机场,再搭乘航班。两步即可闭环。
2.拆解子目标“去机场”:步行到街边,招手拦出租车。
3.拆解子子目标“到街边”:走到电梯口,按下按钮,步出大楼。
4.拆解最底层动作:从座椅上起身,抓起背包,开门避让障碍物。
只有当下沉到“起身离座”这种千锤百炼的本能动作时,规划才可以结束,直接交由系统1的前向神经回路执行。
人类智力之所以与大部分动物拉开鸿沟,本质就在于我们心智模型中所拥有的抽象层级数量。想要打造真正智能的机器,我们就必须教会它构建分层世界模型。
四、彻底弃用生成式AI:JEPA架构如何终结虚妄幻觉
那么,该如何训练这种世界模型?
主流派系给出的方案是直接套用生成式架构——毕竟当下全行业言必称“生成式AI”。
但我在此给出的明确建言是:若想训练真正可靠的世界模型,必须彻底抛弃生成式路线。这番话在硅谷显然极不受待见,但我坚信这是唯一的出路。
大语言模型的训练方式,就是预测一串词里的下一个单词。顺理成章的想法是,只要拿同样的逻辑去预测视频的下一帧像素,机器就能理解客观世界的物理机理。
我在这个死胡同里撞了整整十五年。早在当前技术大行其道之前,我就笃定“视频预测”是通往常识与直觉物理的必经之路。但我过去的大部分实验都以失败告终。直到大约五年前我才彻底想明白:症结恰恰出在“生成式”这三个字上。
为什么?因为真实世界中的绝大多数细节,本质上是根本无法被精确预测的。
假设我用摄像机环视现场:我从演讲台缓慢平移镜头扫过半圈,随后定格,要求AI预测接下来的画面。系统理应推断出镜头会继续转动、台下坐着观众、远处有一面墙。但它绝无可能提前预测在场每一位观众的具体五官细节和坐姿——这些信息根本没有包含在此前的视频片段里。
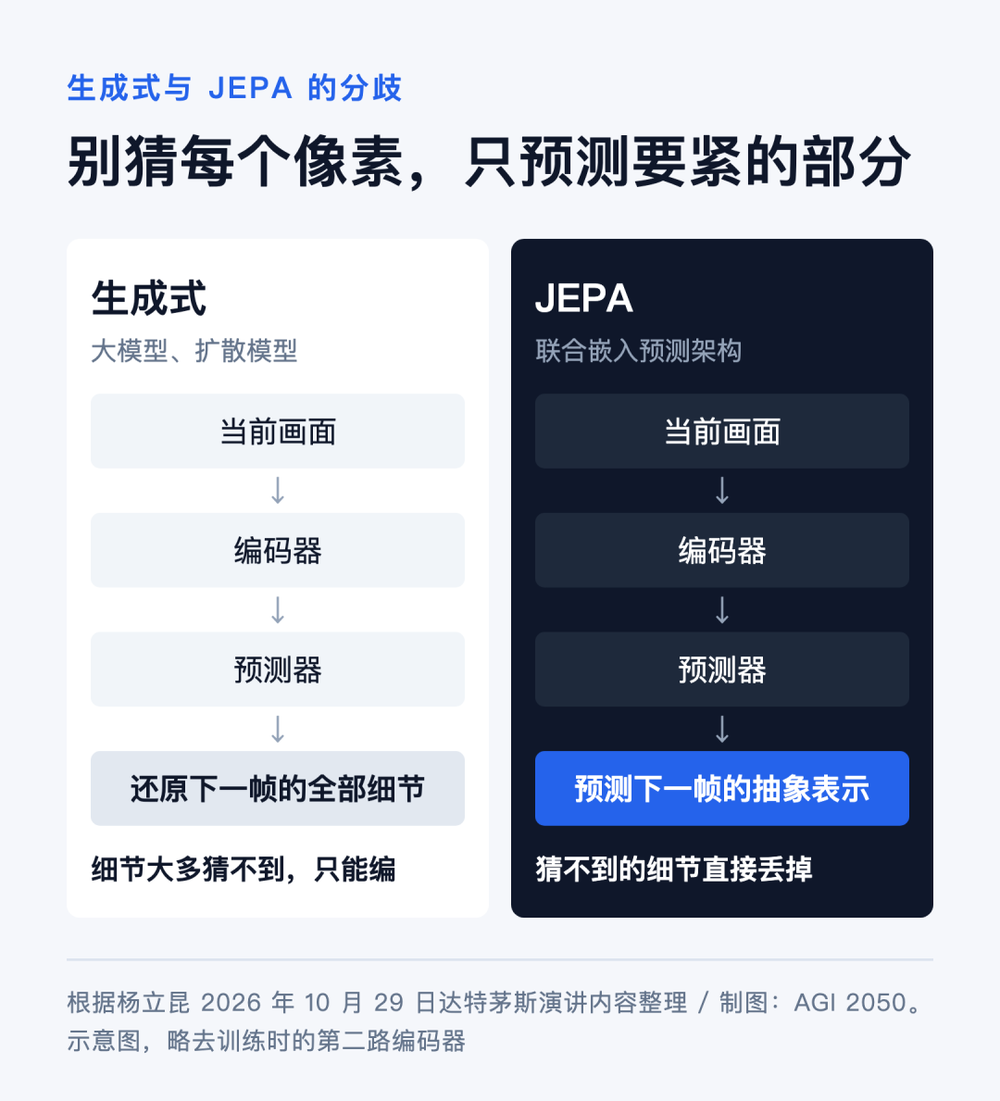
如果强行命令一个生成式模型去还原后续像素,它只能有两种结局:要么输出一片模棱两可的模糊均值,要么借助扩散机制凭空捏造出一群看似合理却完全失真的“幻觉人群”。
让系统去像素级预测不可预测的细枝末节,是在从根本上摧毁其对宏观物理规律的理解。
针对这一死结,我的解法是联合嵌入预测架构(JEPA)。
在传统的生成式架构中,系统试图直接重构原始目标Y;而在JEPA架构中,输入X与目标Y都先经由各自的编码器映射,所有的推演与预测完全在抽象表征空间中展开。
我们永远不要强迫网络去复原Y的每一个微观像素。我们只训练它在抽象隐空间中预测Y的表征,寄望编码器主动丢弃Y中所有不可预测的部分。
人类科学大厦的建立逻辑亦是如此。
从理论上讲,我们完全可以用量子场论和波函数去推导会议室里发生的一切微观物理过程,并以此预测某位学者在一分钟后会不会挠鼻子。但在工程上,这种全维度的微观推演纯属无稽之谈。
面对现实,我们本能地发明了多层级的抽象:
●
从量子场论中抽象出粒子,聚合为原子,构成分子;
●
在生命领域演化出蛋白质、细胞器、细胞、器官、个体、社会乃至生态系统;
●
面对一箱受热气体,我们无需追踪气体分子彼此碰撞、撞上箱壁的过程,只需套用理想气体状态方程(PV=nRT),借助压强、体积与温度三个宏观标量即可做出极其精准的因果预测。
科学的核心奥义,恰恰在于通过抽象过滤掉无法穷尽的细枝末节。世界模型同样不能是像素级的“数字孪生”,它必须是运行在抽象特征空间中、以动作为条件的预测器。
五、攻克表征坍塌:从SIGReg到分层规划
训练JEPA最大的技术鸿沟,在于如何规避表征坍塌。
由于JEPA只在抽象空间对比表征距离,系统极易找到偷懒的作弊解:让编码器彻底忽略输入,无论接收到什么画面,都输出恒定的常数向量。此时预测误差瞬间归零,但模型随之沦为毫无价值的废铁。
为了防止坍塌,我们在损失函数中引入了双重目标:既要最小化状态预测误差,又要最大化编码表征的信息熵。
近年来,我们团队研发出了一种行之有效的正则化新范式——SIGReg(略图各向同性高斯正则化)。
它的数学构想非常优雅:我们将编码器输出的高维特征向量,向大量随机方向进行一维投影。在数学上有一条优美的定理:如果一个联合分布在所有方向上的一维边际分布均呈现为方差为1的标准高斯分布,那么该联合分布整体就是一个各向同性的标准高斯分布。
通过将高维特征投影并借助傅里叶变换将其规整为高斯形态,我们能有效防止信息向单一维度塌缩,迫使系统榨取最具信息量的环境表征。
除了SIGReg,还有一类基于蒸馏的防坍塌方法,我们沿着这条路线构建了诸如V-JEPA等一系列模型。令人振奋的是,在完全没有人工监督、仅通过视频自监督预测掩码特征的情况下,系统自发涌现出了对三维物理空间的深度理解。
如果你提取V-JEPA的内部隐藏表征,再接一个预测头来训练,会发现它能极其精准地预测场景的深度图,甚至能自发解离出物体的物理边界。系统从未被灌输过“空间”的概念,但为了合理预测物理动态,它自发参透了真实世界的空间属性。
在分层规划方面,我们本月刚公布了最新进展:在一个控制四足机械行动的仿真实验中,我们成功训练出了三层世界模型。
●
最底层只预测未来零点几秒,负责规划微观的步态姿态;
●
中间层的表征更抽象、预测跨度更长,在这一层中,模型的肢体细节开始虚化;
●
最高层进一步提炼全局目标,彻底过滤肢体细节,仅在宏观坐标中规划路径并指派阶段性子目标。
实验数据清晰表明,基于这种分层世界模型的推理规划,其任务成功率和算力利用效率均大幅碾压扁平单层的传统系统。
六、告别四大技术支柱:我眼中的下一个二十年
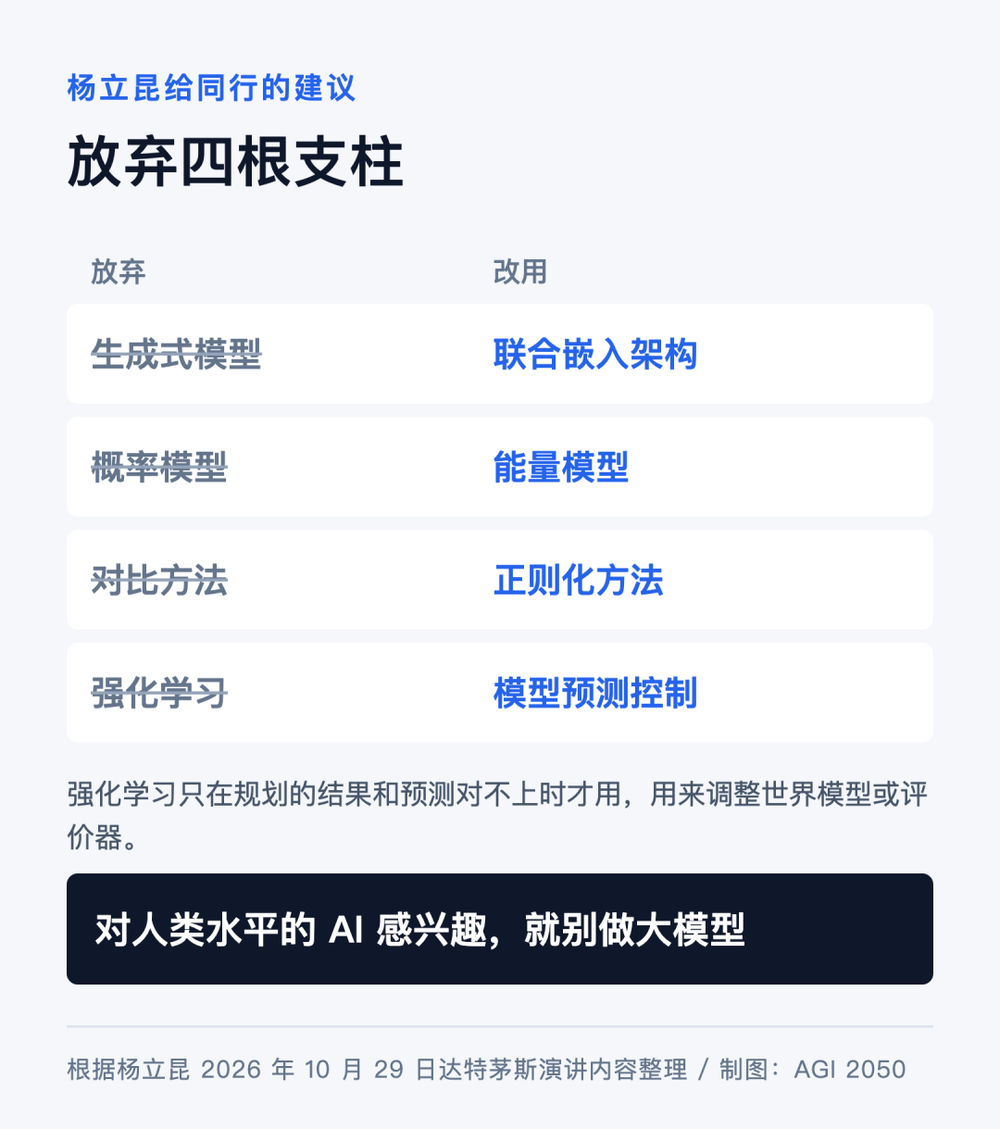
总结今天的内容,我实际上是在呼吁大家告别当前驱动AI行业狂热的四根技术支柱:
1.放弃生成式模型:停止迷信逐细节重建与扩散生成,全面转向以JEPA为代表的抽象表征预测架构;
2.放弃概率模型:转向更为通用、约束更宽泛的能量基模型;
3.超越样本对比学习:对比学习只是信息最大化的一个特例,并非正解,应全面转向各向同性高斯规整这类正则化方法;
4.摒弃简单粗暴的强化学习:传统强化学习极其低效,应尽量少用,以世界模型加规划(模型预测控制)取而代之。
我知道这无异于一场唐吉诃德式的逆行,但这正是我在过去数十年学术生涯中一再经历的过程。十个月前,我主导成立了AMI Labs(在法语中意为“朋友”),其核心目标便是彻底剥离LLM的纯文本狂热,全力押注物理世界AI,将世界模型推进到工业制造、医疗健康与物理科学等广袤的实体疆界中。
有人问我,能否为未来二十年做出一个明确的预言?
无需等待二十年,我给出一个时间跨度更近的预言:
我们将在物理实体领域迎来又一场真正的AI范式革命。当通用家务机器人真正走进千家万户并能够自如打理日常时,就标志着这场革命彻底完成了。
这不会明天就发生,也绝非仅靠大语言模型缝缝补补就能达成,它依赖于底层的科学突围——也许有人会想出更好的办法,但我认为关键是让系统具备预判行动后果的世界模型。
另外我要强调:如果未来某天我们真的目睹了接近人类心智的机器,我猜它的背后会有一个世界模型,并会用上某种形式的规划,而且其绝大部分深度思考不会发生在语言维度。
人类往往过分拔高了语言对于思考的意义。动物没有语言,却能进行极其复杂的因果逻辑思考;失语症患者大脑的语言区受损,抽象思维却依然完好。
将语言直接等同于思维,是认知层面的狭隘偏见。除了纯数学与编程这种高度依赖离散符号系统的小众领域,我们绝大多数的推演都是在抽象心理表征中进行的。
比如,请在脑海中想象一个悬浮在眼前的正方体,再让它绕着垂直轴旋转90度。你眼前会立刻浮现出清晰的几何画面,并本能地意识到它与原状严丝合缝——这一心智推演过程没有半点文字的参与。
再考一考在座稍微懂点线性代数的朋友:请在二维平面上构想出三个线性无关的向量。
我不需要你们回答,因为答案显然是不可能的。但我更好奇你们刚才的心智过程:我敢断定,全场绝大多数人脑海中瞬间浮现出的是平面几何坐标图景,你们立刻看到其中必有一个向量是另外两个的线性组合;只有极少数人会机械地背诵教科书定理。那些真正卓越的科学家和工程师,无一不是在脑海中凭借高度清晰的空间与物理意象建立直觉,正如爱因斯坦当年骑着光子驰骋的著名思想实验一样。
真正的智能,永远深植于对客观物理现实的直觉建模之中。
非常感谢各位。
资料来源:达特茅斯学院AI@70大会,杨立昆主题演讲,2026年10月29日,https://www.youtube.com/watch?v=7Yr62DCtIVs