AI 开始挑战最复杂的系统:生命
2026 年的 AI 赛道,正在发生一个有意思的转向。当行业目光还聚焦在大模型参数、智能体和通用超级智能上时,扎克伯格把资金押向了一个更棘手的领域:生命系统。
今年 4 月,扎克伯格与妻子普莉希拉・陈创立的 Biohub,启动虚拟生物学计划,投入 5 亿美元搭建配套的数据与实验能力,用来训练能预测生物现象的 AI 模型。到 10 月,这个项目进一步扩大。美国能源部、美国国立卫生研究院和 Biohub 联手,搭建生命预测模型的数据底座,Meta、谷歌 DeepMind、Isomorphic Labs 一同参与。整个项目合计承诺投入 18 亿美元,其中美国能源部未来五年拿出超 5 亿美元,NIH 开放大量已积累的生物医学数据。
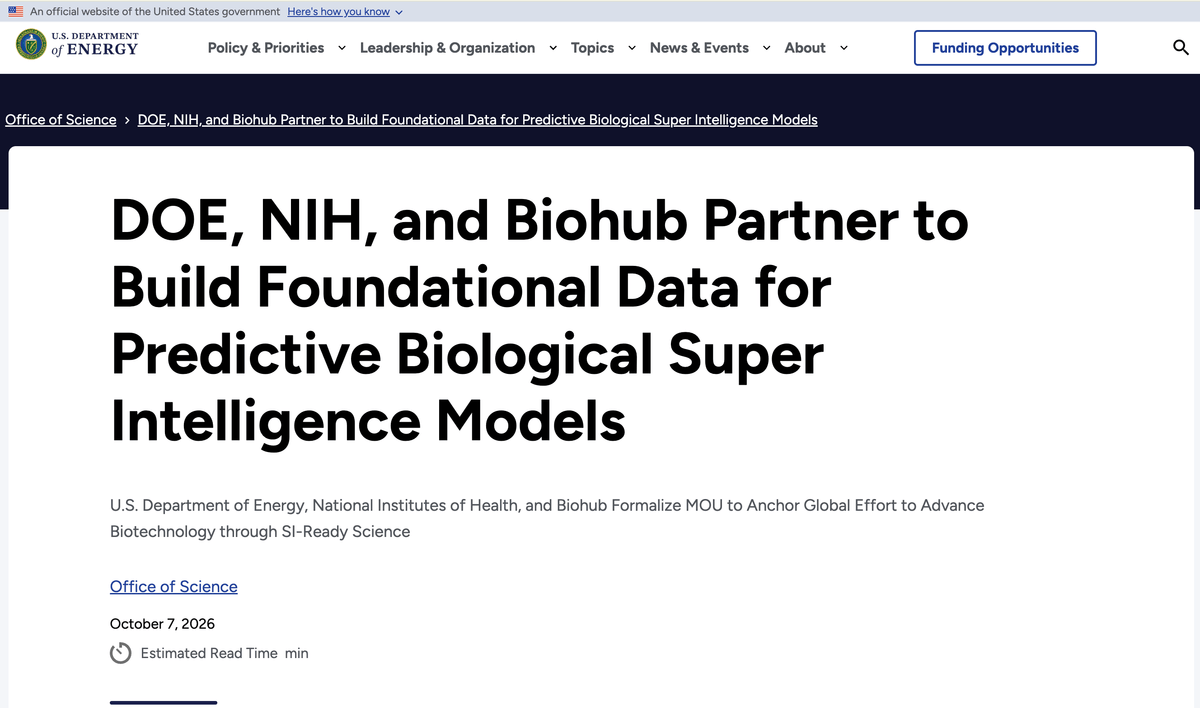
这个项目的目标很直接:打造一套可以预测生命行为的 AI,Biohub 称之为虚拟生物学。简单说,就是搭建从分子、基因、细胞,一直到完整生命系统的高保真数字版本。科研人员未来可以像现在提问大模型一样,在电脑里对生命做假设、模拟干预,先完成数字试验,再去实验室做真实实验。
这件事不只是扎克伯格单纯看好生物医药。更深一层看,生命科学正在变成 AI 竞争的第二战场。通用大模型赛道已经烧钱白热化,算力、人才、资本门槛越来越高;而理解生命系统,还是一片没有定型的前沿。谁能让 AI 真正读懂生命,就能建立起比聊天机器人难复制得多的壁垒。
AI 擅长设计分子,但新药研发依旧艰难
AI 和生物医药的结合,并不是新鲜事,也是 AI 最早被寄予产业化期待的方向之一。但十几年走下来,一个核心疑问始终摆在眼前:我们真的离新药更近了吗?
近几年 AI 制药最亮眼的成果,基本都集中在分子层面:蛋白质结构预测、候选分子筛选、分子生成、药物安全性预测、药物靶点相互作用等等。AI 能够一次性产出成千上万候选分子,大幅拓展可供筛选的化学空间,效率提升是实实在在的。
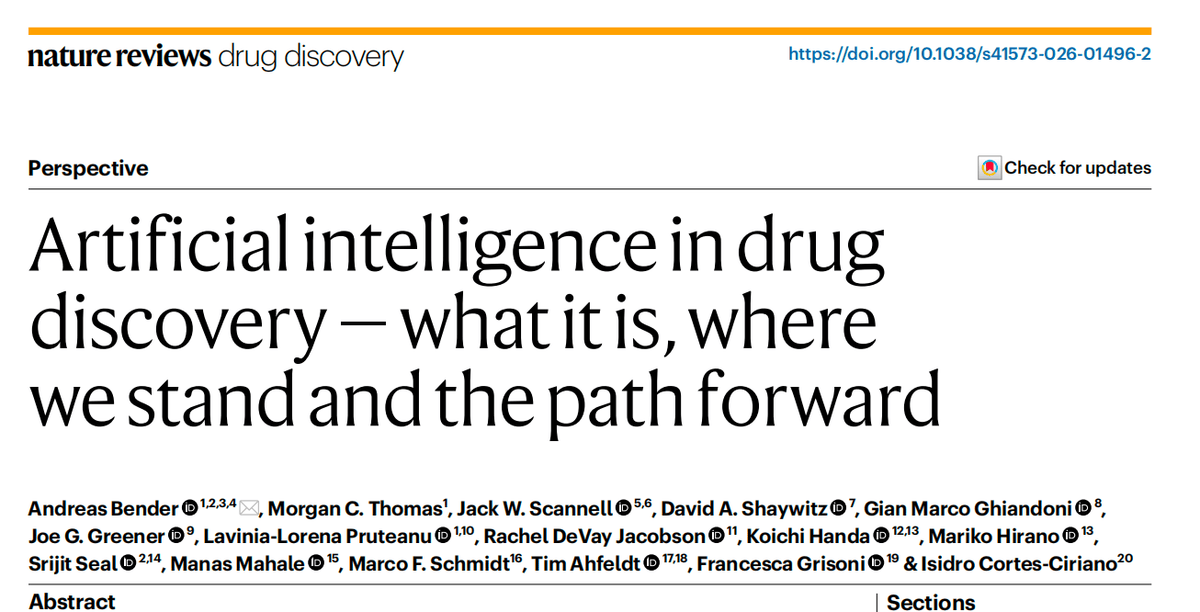
可如果把评判标准从模型跑分,落到一款新药成功上市,现实就没有那么乐观。今年 8 月《Nature Reviews Drug Discovery》发文复盘十多年 AI 制药的发展:虽然各类 AI 算法层出不穷,但真正能产生临床价值的成果依旧有限。很多 AI 药企的项目停留在临床前或者一期、二期临床,进入三期临床的项目很少。
小分子生成方向上,AI 确实更容易找到能和蛋白结合的分子,但这只是配体设计,不等于药物设计。找到一个能绑定靶点的分子,和找到一个在人体内安全有效的药物,完全是两码事。
这也是行业当下最值得反思的地方。过去我们把复杂的生命问题做了简化。AI 擅长回答 “什么分子可以结合这个靶点”,但新药研发真正难的是一连串系统问题:这个靶点为什么会引发疾病?干预靶点之后,人体整套生命系统会产生哪些连锁反应?为什么同一种药,有的人有效,有的人无效?为什么细胞、动物实验效果很好,到人体临床试验就失败?
药物分子不是孤立起效。它进入的是一套动态复杂系统,基因、蛋白、细胞、组织、器官、免疫、代谢,再加上外部环境,所有因素互相影响。药物能不能成功,关键恰恰就在这套系统里。 由此带来一个根本性问题:如果 AI 只能看懂分子,看不懂完整生命系统,那它能把新药研发带到哪一步?
从单点分子模型,走向生命世界模型
这也解释了 2026 年 AI 生命科学的核心变化:建模尺度不再局限于单个蛋白、分子或者细胞,开始向上延伸,构建生命预测模型。目标不再只是预测蛋白结构,而是刻画生命状态,预判系统受到干预后的变化,模拟细胞面对扰动时的反应,也就是业内所说的生命世界模型。
大语言模型学习语言的规律,物理世界模型学习物体运动与空间规则,生命世界模型面对的规则要复杂得多。基因变异改变蛋白表达,蛋白调控信号通路,信号改变细胞状态;细胞之间相互作用形成组织微环境,层层向上影响器官乃至人体。生命本身不是静止的,会生长、衰老、产生代偿、发生突变,还会对外界干预持续反馈。
所以生命世界模型,不是一本静态的生命百科。它的核心是弄懂生命如何运转,预测当某一个变量被改变之后,整个系统后续会如何演变。
一旦这套模型落地,AI 在医药研发里的定位会彻底改变。 旧模式:给定靶点,快速寻找候选分子。 新模式:给定一种疾病,先搞清楚发病根源,再判断该干预哪个位置、哪些患者能从中获益,预判干预带来的全身连锁反应。 同样是 AI 赋能新药,两种模式要解决的问题已经完全不一样。
国内同步布局:计算医学写入国家规划
这场转型不是美国独有,国内 AI 生命科学也在从单点算法,转向系统性疾病建模。
今年 9 月,工信部、发改委等十部门发布《医药工业发展 “十五五” 规划》,计算医学首次和 AI、量子计算、超算并列,纳入医药工业未来五年重点技术方向。 AI、超算提供强大的通用计算能力;而计算医学解决的是,怎么把这些算力对接生命系统,用来解决真实疾病问题。
国内哲源科技就是走这条路线的团队。它没有单纯去训练一个更大的生物大模型,而是围绕疾病本身,整合基因组、细胞特征、疾病机制、患者数据、药物干预信息,搭建多层级计算模型,尝试构建一套可以持续推演、训练、验证的生命世界模型体系。
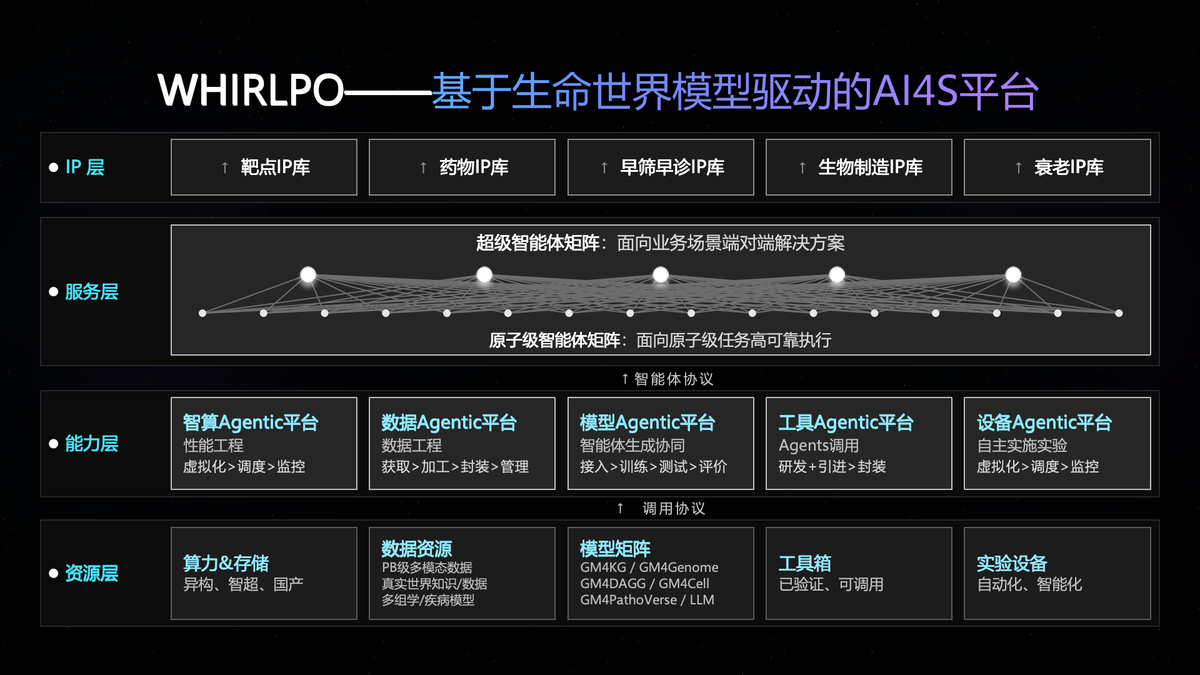
10 月 17 日,哲源科技发布 WHIRLPO 计算医学平台。它并不是一款独立的生物大模型,而是解决更底层的工程难题:如果生命世界模型是下一代生命科学的基础设施,我们需要一套底座,支撑这类模型的训练和运行。
搭建生命世界模型,难度远超训练大语言模型
生命世界模型的落地难度,很容易被低估。 第一是数据难题。大语言模型有海量互联网文本作为养料,但生命领域没有统一的数据集。基因组、单细胞、空间组学、病理、影像、临床数据来源分散,格式、质量、观测尺度差异巨大。很多高价值数据,还需要专门做实验才能产出。Biohub 投入的 18 亿美元,很大一部分资金就是用来生产生物数据,而不是单纯训练模型。
第二是多尺度建模难题。不存在一个大一统的生命模型。研究 DNA 突变、细胞状态、组织微环境、人体疾病,需要不同模型配合。未来完整的生命世界模型,大概率不是单一巨型模型,而是多模型、知识库、工具协同工作的复合系统。
第三是异构算力工程挑战。模型预训练、组学分析、疾病演化模拟、数字患者推演,计算方式各不相同,需要灵活调度 CPU、GPU 等各类算力资源,会遇到传统大模型很少面对的大型科学计算工程问题。
第四,生命模型必须打通计算世界和真实实验世界。语言模型回答出错,可以直接重新训练;但生命模型给出的靶点假说,必须进入实验室验证,实验结果再反过来修正模型,最终还要接受临床检验,模型结论不能只在电脑里自洽。
WHIRLPO 平台正是瞄准这个痛点:整合异构算力、多组学生命数据、模型矩阵、科研工具、智能 Agent 和实验验证链路,搭建从模型训练、科学计算到湿实验闭环验证的基础设施。简单来讲,哲源不是只做模型,而是为生命世界模型打造生产底座。
AI 生命科学,进入基础设施竞争阶段
2026 年,中美两地出现了行业共振。 美国这边,Biohub 联合能源部、NIH、Meta、DeepMind 一起搭建生命 AI 所需的数据、算力、实验基础设施; 国内这边,计算医学写入十五五医药规划,本土团队开始搭建生命世界模型的工程平台。
两件事看似独立,本质指向同一个判断:AI 生命科学,已经从比拼模型指标,进入基础设施竞争时代。
过去行业比拼的,是谁的蛋白预测更准、谁生成分子效果更好、谁能把某一个研发环节提速。 下一阶段比拼的核心,变成:能不能拿到大规模高质量生命数据;能不能跨越基因、细胞、组织、人体不同尺度建模;能不能把多个模型协同调度;能不能让模型持续和真实实验闭环验证;最终实现 AI 从处理生命数据,升级为理解生命系统。
AI 制药过去十几年,方向并没有错。我们此前攻克的,只是生命问题里相对容易计算的那一部分。 分子固然重要,但药物治疗的对象不是分子,是人。从一个候选分子,到在人体上产生疗效,中间隔着一整套完整复杂的生命系统。
如果生命世界模型成为继语言模型、物理世界模型之后,AI 的下一个核心方向。未来最大的机会,未必属于那些小幅刷新模型指标的团队。 真正稀缺的资产,不是又一个生物 AI 模型,而是一套能够让 AI 走进真实生命世界的完整基础设施。
本文由哲源科技提供,量子位获授权转载,观点归原作者所有。