100轮图像编辑这道「毙刷题」,新出的Seedream 5.5稳上来了!
金磊 发自 凹非寺
量子位 | 公众号 QbitAI
说真的,即便强如新出的GPT-Image 2.6,遇到连续编辑100轮图像这种高压任务,也得大喊那句“名人名言”:
我画地为牢啊,厉娜!
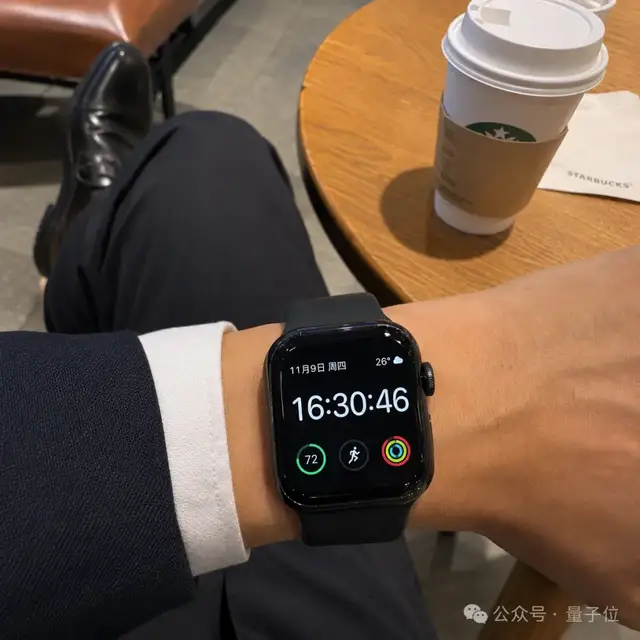
例如我们先给Image 2.6输入下面这张原始图片:
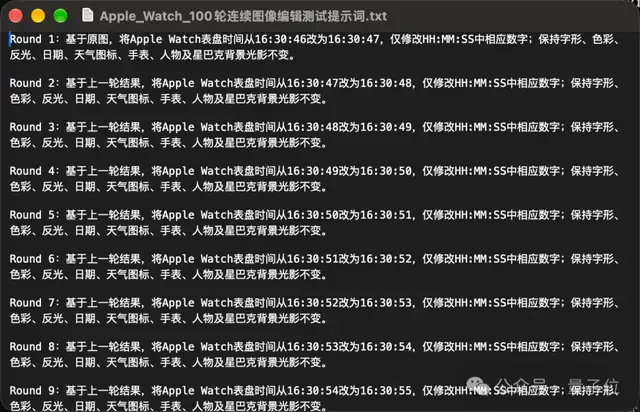
然后再把包含100轮任务的提示词丢进去,每一轮就是让手表里的时间增加1秒钟,并且把上一轮生成的图片作为下一轮的输入:
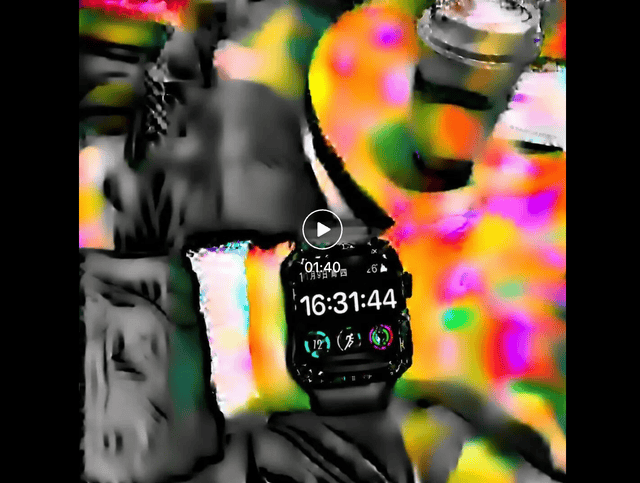
但看似非常简单的任务,Image 2.6生成的结果却是这样的(为了方便看变化,我们把100张图做成了一个视频)……
视频地址:
https://mp.weixin.qq.com/s/_OgVL6s3PIguqFN-WN1mhQ
可以明显地看到,其实在第10轮左右,原始图片就开始发生了畸变,而且越往后,图片失真程度就越严重。
这要是放到真实工作场景里,那简直就是大大大大麻烦了。
But!!!
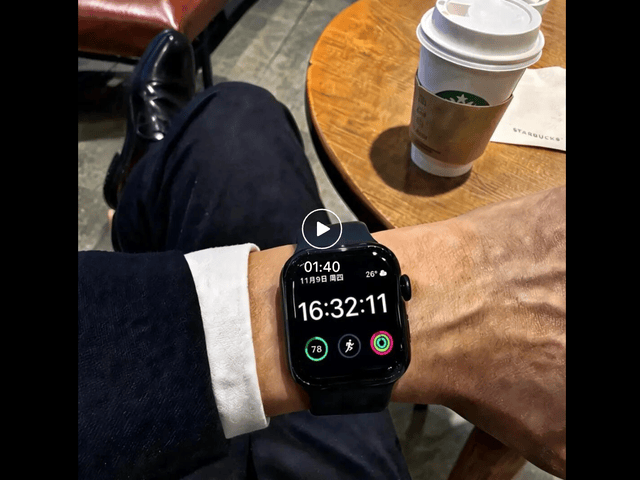
一个新出的国产生图AI,却能hold住这个高压任务!来看下结果:
视频地址:
https://mp.weixin.qq.com/s/_OgVL6s3PIguqFN-WN1mhQ
虽然在后期的轮数中,依旧是存在一些畸变的情况,但整体却要比Image 2.6要保真得不少。
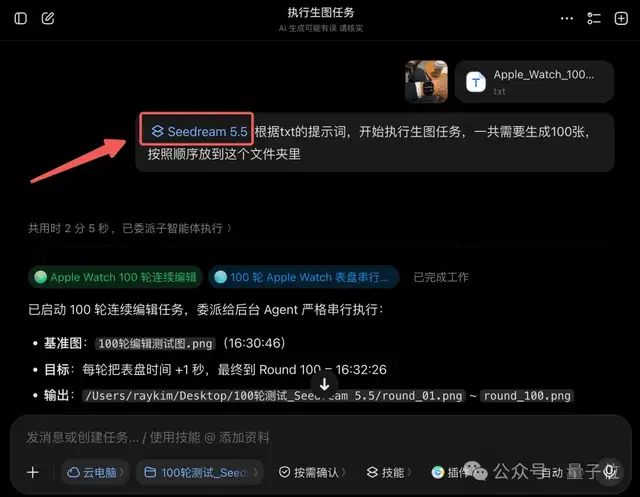
而这个新国产生图AI,正是来自字节的Seedream 5.5。
上面的任务,便是在豆包里调用新模型来执行的。
不过,100轮编辑不崩,还只是Seedream 5.5这次更新的一隅。整体看下来,它的亮点还包括:
- 真实感提升:人物、材质和光影更像真实拍摄的,几张图拼在一起也不容易穿帮;
- 小字与多语言渲染:海报、标签、信息图里的字基本不会写错,还支持多种语言;
- 透明图生成与编辑:能直出透明底的图(PNG),省掉繁琐的抠图;也能把成图拆回图层,单独改文案、出不同语言的版本。
不仅如此,Seedream 5.5现在生成的速度也比之前的版本要快上不少;与此同时,据官方信息,Seedream 5.5 API延续“输入图 + 输出图”两段计费结构,文本 Token 不产生费用。以2K方图编辑为例,单张成本在 0.28 元左右,不到 Seedream 5.0 Pro 一半。
光说不练假把式,那么接下来,一波深度实测走起~
来一波“可劲儿造”的实测
更复杂的连续编辑
第一轮实测,我们就在豆包里,再来一波更复杂的连续编辑任务。
刚才的100轮编辑,只是针对图片里手表的时间来展开;而这一次,我们基于一张写实的客厅照片,对各个细节内容做连续编辑:
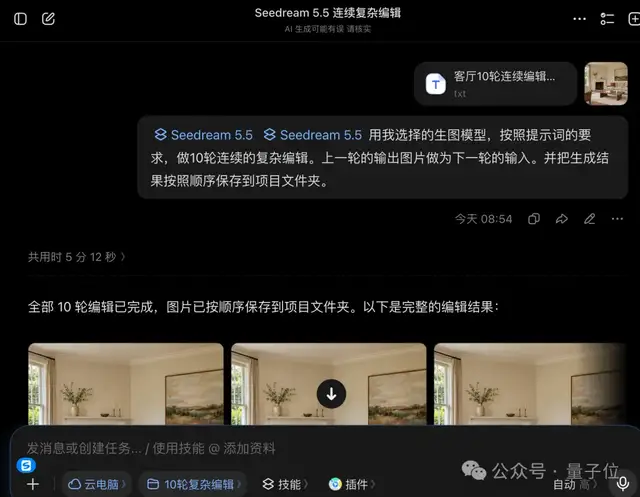
为了方便看效果的对比,我们依旧是把10张照片做成了视频:
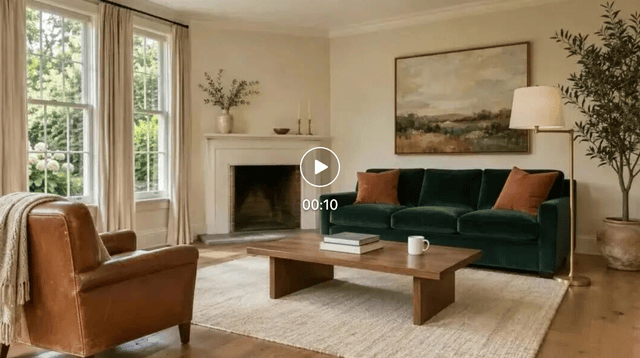
视频地址:
https://mp.weixin.qq.com/s/_OgVL6s3PIguqFN-WN1mhQ
这一轮考验的正是大模型的记忆力。
因为每一轮的输入都只是上一轮的输出,模型看不到最初的原图,所以后边的步骤,若是一步错,便会步步错,误差是会累积的。
而这正是Seedream 5.5这次主打的精准编辑与多轮一致性。
合成一张高端广告
第二轮实测,我们来一个贴近工作场景的任务——多图合成广告。
为此,我们提前先准备好了三张输入图片,分别是一张女性模特图、一张包包图,以及一张背景图:
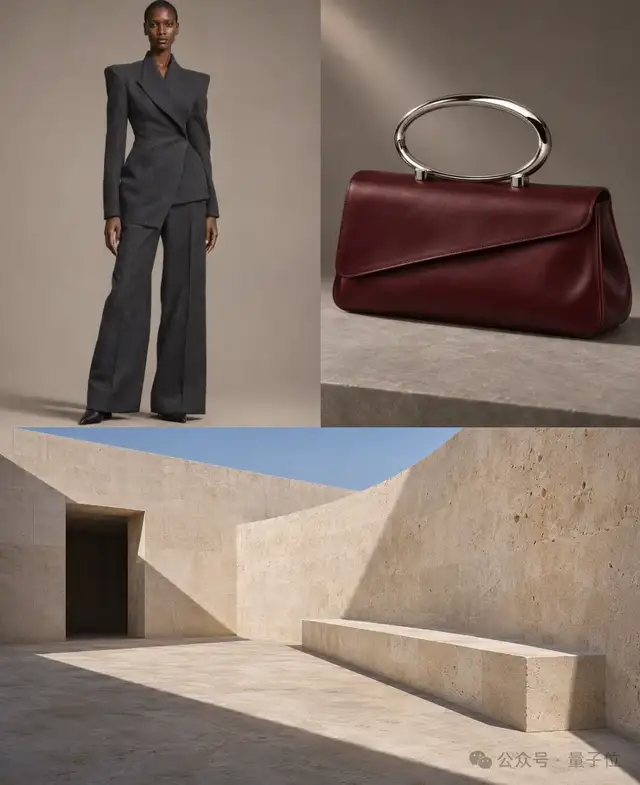
然后提示词也是比较简单:
请将上传的三张参考图融合成一张高端时装品牌的手袋广告主视觉。输出一张16:9横向、尽可能高分辨率的超写实摄影作品。
仅仅1分钟后,高端商品广告大片就做好了:
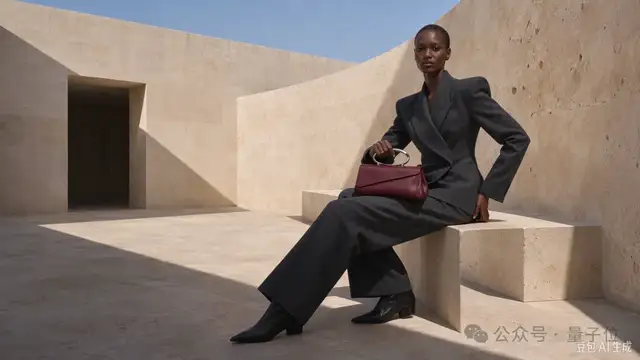
这三张输入图的拍摄条件完全不同:模特是影棚柔光,手袋是静物侧光,背景则是户外直射阳光。
而多图融合的难点,就在于要让它们看起来像是同一次拍出来的。
从成片来看,模特从站姿换成了坐姿,西装面料、手袋的斜翻盖和金属环提手都保留了下来,手袋的大小也符合真实比例。
这正是Seedream 5.5在多图融合上的升级:主体之间的尺寸、透视和光照关系更协调。
包括一些半透明的PNG素材,Seedream 5.5现在的组合能力也是相当之稳。例如我们这次直接上传5张PNG:
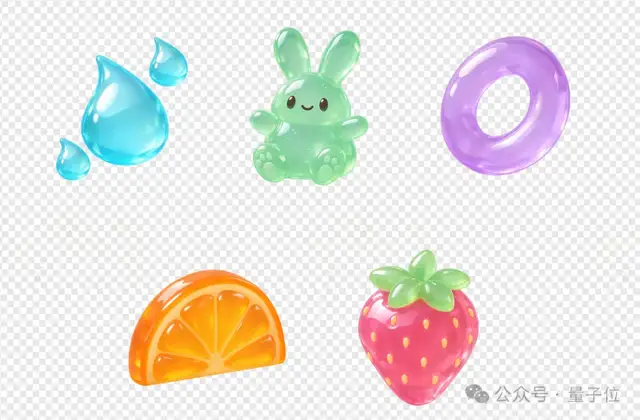
然后附上这样的Prompt:
使用上传的5张透明PNG素材,组合并重新渲染为一张完整的卡通果冻风格主视觉。画幅16:9,分辨率3840×2160。主题为“果冻水果漂浮乐园”,像高品质动画电影的甜品世界宣传画,清新、轻盈、有明确构图和空间层次。
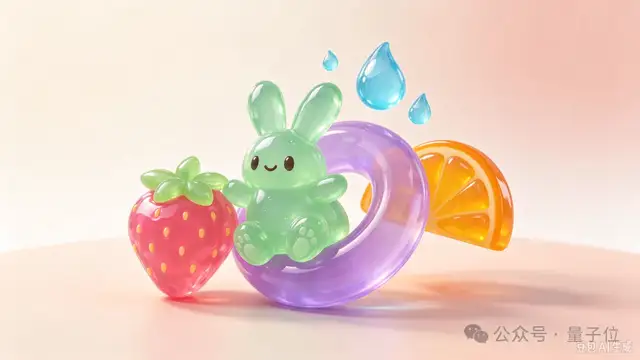
半透明素材,一直是生图模型的难点。
因为透明PNG的边缘处理不好,就会出现白边、灰边;而果冻这类材质,还要处理透光、折射和带颜色的阴影。
从结果来看,紫色圆环能透出后面橙子的颜色,地面阴影也带着各自素材的色调,前后遮挡关系也很清楚。
还以为是电影截图
说到真实感,就不得不测一下AI生成电影感镜头画面方面的能力了。
这一次大致的提示词如下:
凌晨五点,冬季的巴黎,一家尚未营业的老咖啡馆内,一位四十岁左右的女性独自坐在临街窗边,身穿深灰色羊毛大衣,围巾松开,双手自然围住桌上的白瓷咖啡杯……
虽然我们让Seedream 5.5一口生成五张2K高清图片,但速度可以说是极快的,几乎就是在1分钟内 完成:
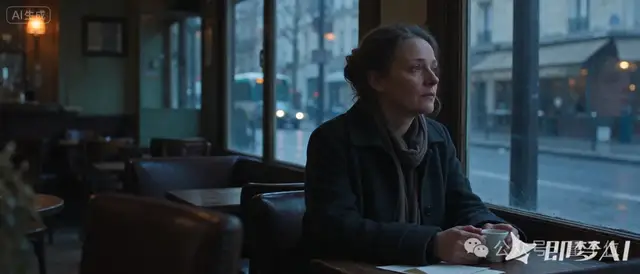
判断一张图像不像电影截图,首先要看光。
这张图里有两种光源:窗外凌晨偏冷的天光,和店内暖黄色的壁灯,人物脸上和大衣上的冷暖过渡得很自然。
细节上,窗玻璃上有人物淡淡的倒影,窗外的街道、车灯做了浅景深处理;人物的皱纹、松开的围巾和略显疲惫的神情,也更像真实的普通人。
对影视行业来说,这样的画面已经可以用于前期概念图、分镜和氛围参考。
超多字的海报轻松hold住
除了真实感之外,好的生图AI还得是能稳稳拿捏超多小字的科学海报的。
为此,我们就让Seedream 5.5围绕最近比较火的“世界模型”来做一张:
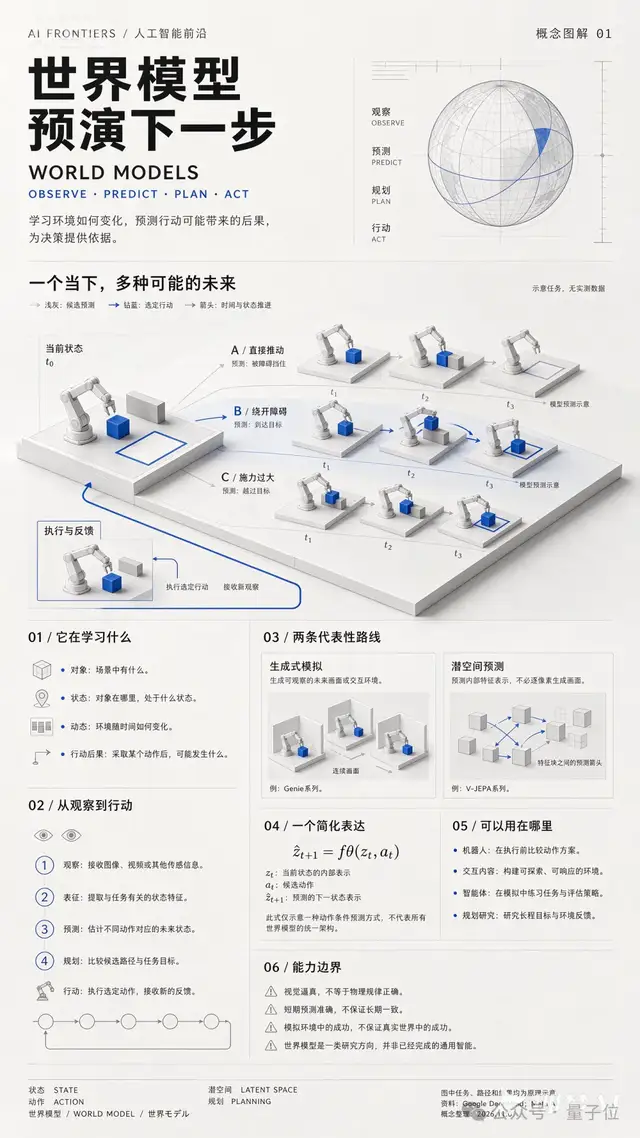
这张海报的信息密度非常高,从主标题、模块标题、正文小字到页脚的资料来源,至少有四五层字号。
即便放大看最小的那一层,文字依然清晰,几乎没有乱码。
除了中英文,页脚还有一行日文“世界モデル”,公式里的上下标、变量说明也都一一对应;插画里A、B、C三条路径和t1、t2、t3的标注,也和文字说明对得上。
这对应的正是Seedream 5.5的小字与多语言渲染,以及图文排布能力。
看一眼动作就能“模仿”
这次升级后的Seedream 5.5还有一个特点,那就是它对于复杂动作是可以做到看一眼就会的。
例如我们准备了一张最近比较火的闪身步照片,以及一张人物图像:
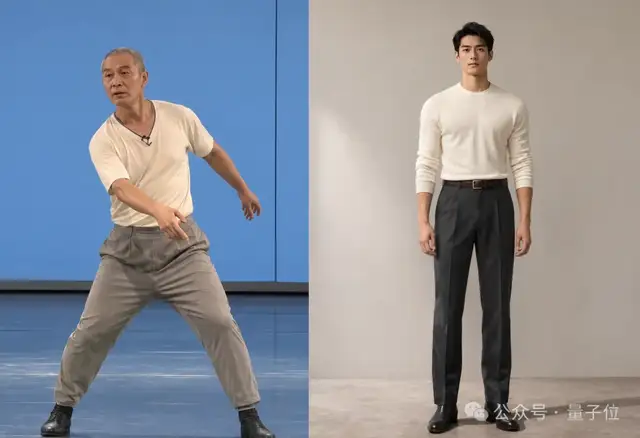
我们把这两张图一次性“喂”给豆包,然后简单来一句:
让参考图里的人物,做原始动作图里人物的动作,输出16:9的图像。
同样是仅耗时1分钟,动作就直接迁移好了:
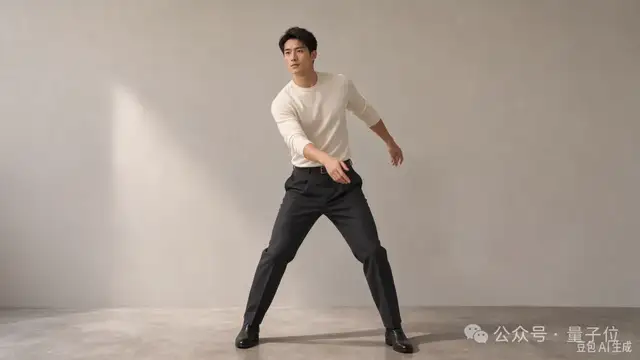
这个任务的难点在于动作要从第一张图里拿,人物要从第二张图里拿,两边的信息还不能串。
从结果来看,大跨步的站姿、重心偏移、手臂的位置都迁移了过来,连侧头的神态也跟上了;而人物的长相、穿着和影棚背景,都和原图保持一致,画幅也扩展成了16:9。
而且即便是一口气输入9个人的图像,Seedream 5.5依旧能把他们按照指定的姿势稳稳地给生成出来:
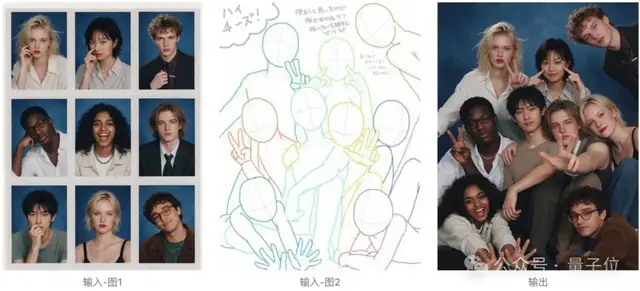
这背后,便是Seedream 5.5对人体姿态的理解,以及对人物一致性的保持。
拆分成可编辑的图层
下面的实测,是一波反向操作。
我们先准备了一张成品的图像,目标是先把图里的各个关键元素给拆出来,然后再按需编辑成不同版本。
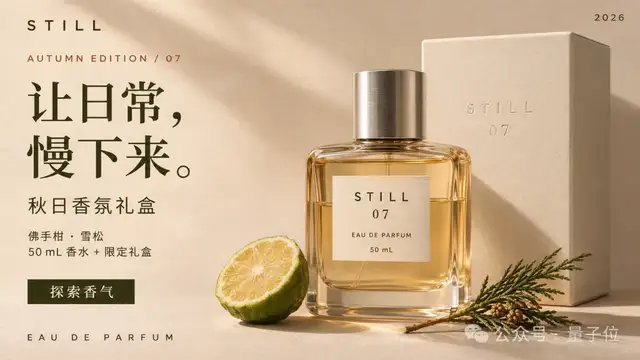
拆分图层的Prompt是这样的:
请将这张香水广告成图拆分为可继续编辑的图层,保持原画布16:9、原始构图、比例、色彩和物体位置。使用实际图层拆分与文字识别功能,不生成“图层示意拼图”。
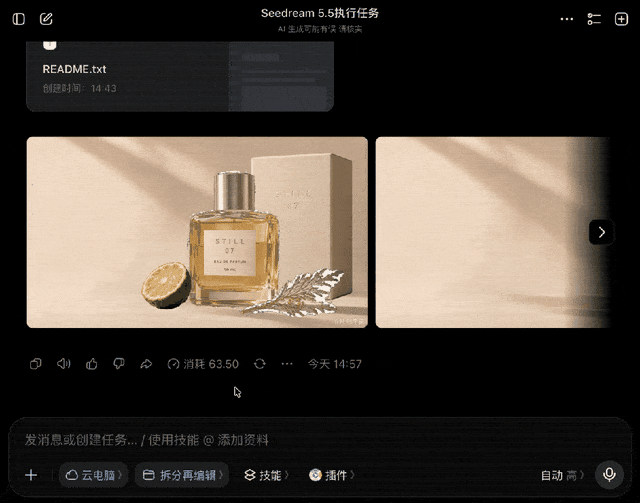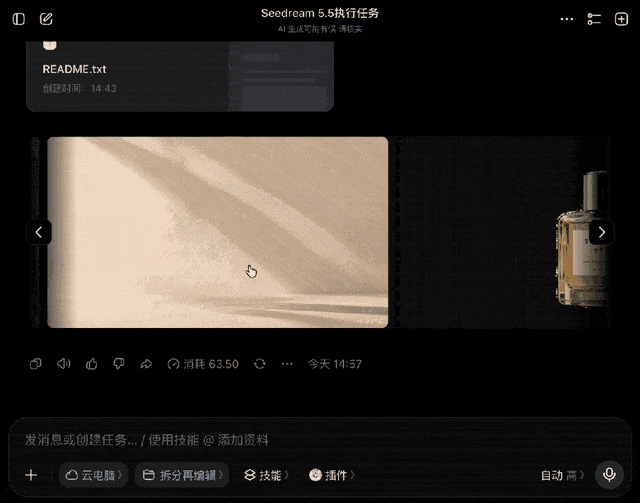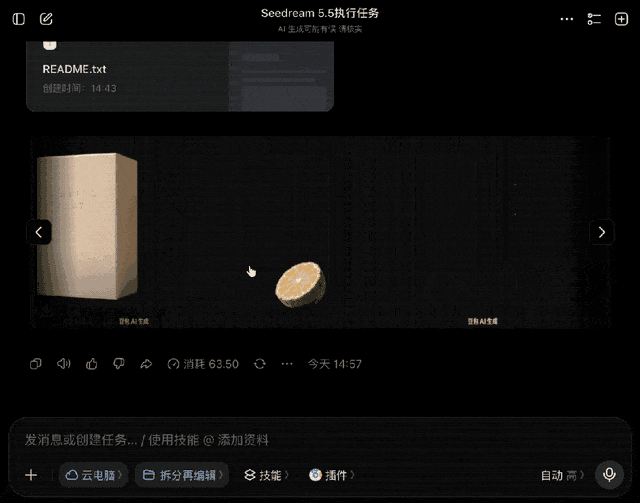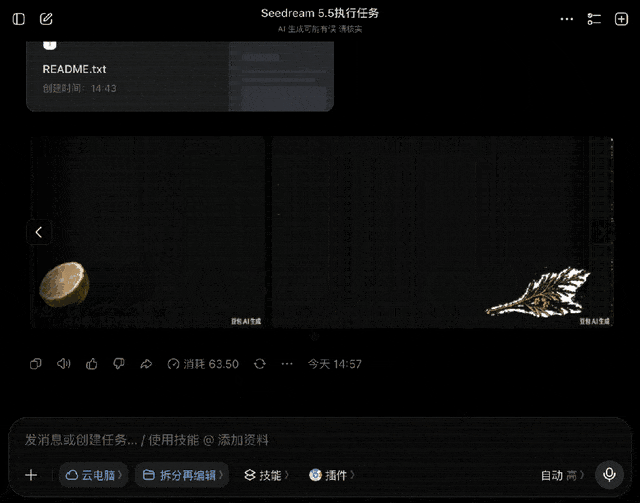
可以看到,商品图已经被Seedream 5.5按照要求拆分成了不同的图层。
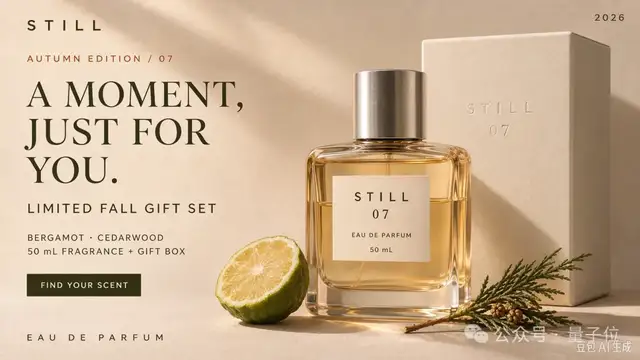
接下来,我们就继续让它做细节的调整,变成适合英文市场的商品图。Prompt大致如下:
基于已经完成拆分的原始广告项目制作本市场版本。不能依次翻译上一市场版本。输出一张16:9、3840×2160的完整广告成图,并在入口支持时同时保留可编辑项目。
锁定背景、香水瓶、礼盒、佛手柑、雪松枝及其阴影图层,保持它们的位置、尺寸、透视、色彩、材质和光照不变。保留所有商品包装上的STILL、07、EAU DE PARFUM和50 mL,不翻译、不重新绘制包装标签。画面上的STILL字标、AUTUMN EDITION / 07、2026及底部EAU DE PARFUM也保持不变。
为什么要拆图层?
因为以前AI生成的成图是“一整块”,哪怕只改一句文案,也得整张重新生成,或者让设计师手动修。而拆成图层后,改字就只动文字层,其他部分原封不动。
对比两张图可以看到,背景、香水瓶、礼盒、佛手柑、雪松枝和光影都和原图一致,包装上的STILL、07、EAU DE PARFUM也一个字没动。
变的只有文案,而且并不是逐字直译:“让日常,慢下来”变成了“A MOMENT, JUST FOR YOU.”,“探索香气”变成了“FIND YOUR SCENT”,字体也换成了适合英文的衬线体。
这一步用到的,正是Seedream 5.5的图层拆分与文字二次编辑能力。
对出海品牌来说,这就意味着一套主视觉,可以快速做出多个市场的版本。
GIF?当然也可以
最后,我们来实测一下之前Image 2.6火爆的GIF玩法。
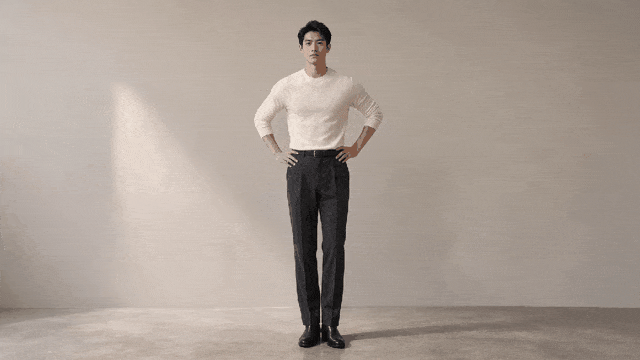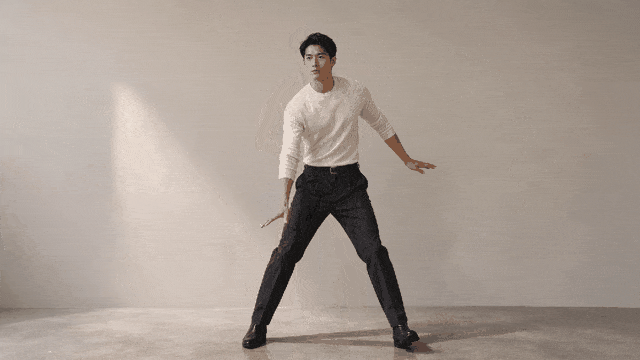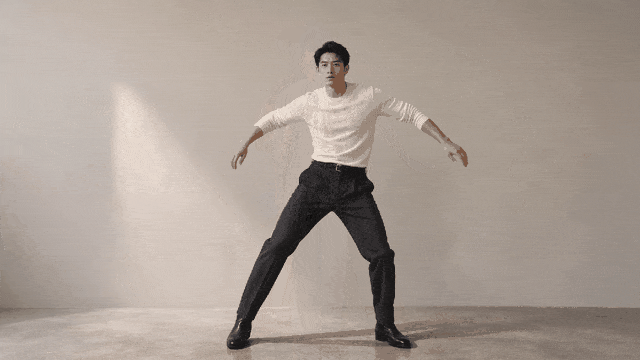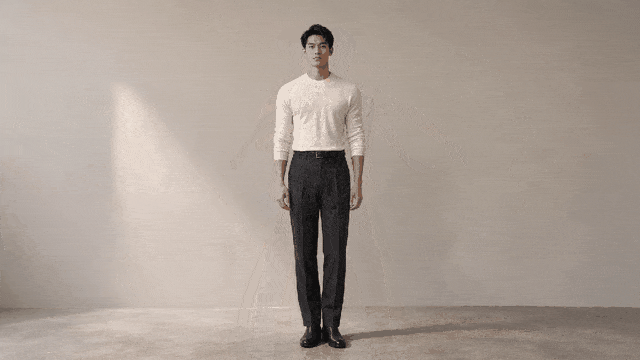
图片还是直接沿用刚才“闪身步”的那个案例,这一次我们让它动起来。Prompt如下:
在网上搜索一下“闪身步”完整的视频或GIF,用刚才生成好的人物和Seedream 5.5,制作一个GIF,16:9,大小不能超过10M,尽量保持高清。
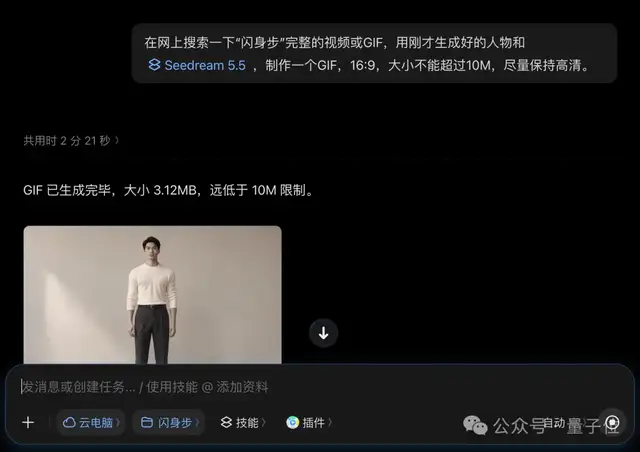
然后,一个符合要求的GIF,就这么水灵灵地诞生了:
所以,从整体实测结果来看,Image 2.6能做到的,Seedream 5.5也能做到;Image 2.6做不到的,Seedream 5.5还是能做到。
香!
Seedream 5.5:不用画地为牢了,厉娜
有一说一,现在生图圈子里,真的已经不缺能出好看图片的AI了。
缺的是在编辑、改动50次,甚至100次的时候,还能保持稳定的那种AI。
这其实也是在这次实测过程中,Seedream 5.5让我们印象最深的一点。
而改得准、改得稳,恰恰是电商场景最需要的。
商品图、电商主图几乎每天都要二次修改,换个颜色、换套衣服、换张背景,或者改句文案。现在这些都能在同一张主图上连续完成,一张图就能衍生出一整套SKU版本;再加上透明图直出、图层拆分和多语言改字,中间好几道工序都能省掉。
影视和内容制作同样能用上。
因为多图融合时,人物、道具和场景之间的尺寸、透视和光照都能对得上,参考图就可以直接合成概念图和分镜;而像巴黎咖啡馆那样的真实感,也足以进入前期视觉开发。
设计和营销物料也是如此。
海报、信息图和活动页里最磨人的就是小字,以前设计师还得一个个补字、修字,现在密集文案和多语言文字可以直接排好。
再加上前面提到的价格优势,能力接近第一梯队,价格却在往下走,对每天要大量出图的中小商家和内容团队来说,这笔账很好算。
最后,再回到开头那句“名人名言”。
在100轮编辑这种最考验基本功的任务上,Image 2.6“画地为牢”了,而Seedream 5.5则证明了,国产模型在多轮编辑稳定性上,已经走到了国际头部模型的前面。
目前,Seedream 5.5已经在即梦、豆包和豆包工作上线,感兴趣的小伙伴可以亲自试试喽~
One More Thing
再来一起欣赏一些Seedream 5.5生成的惊艳图片吧: